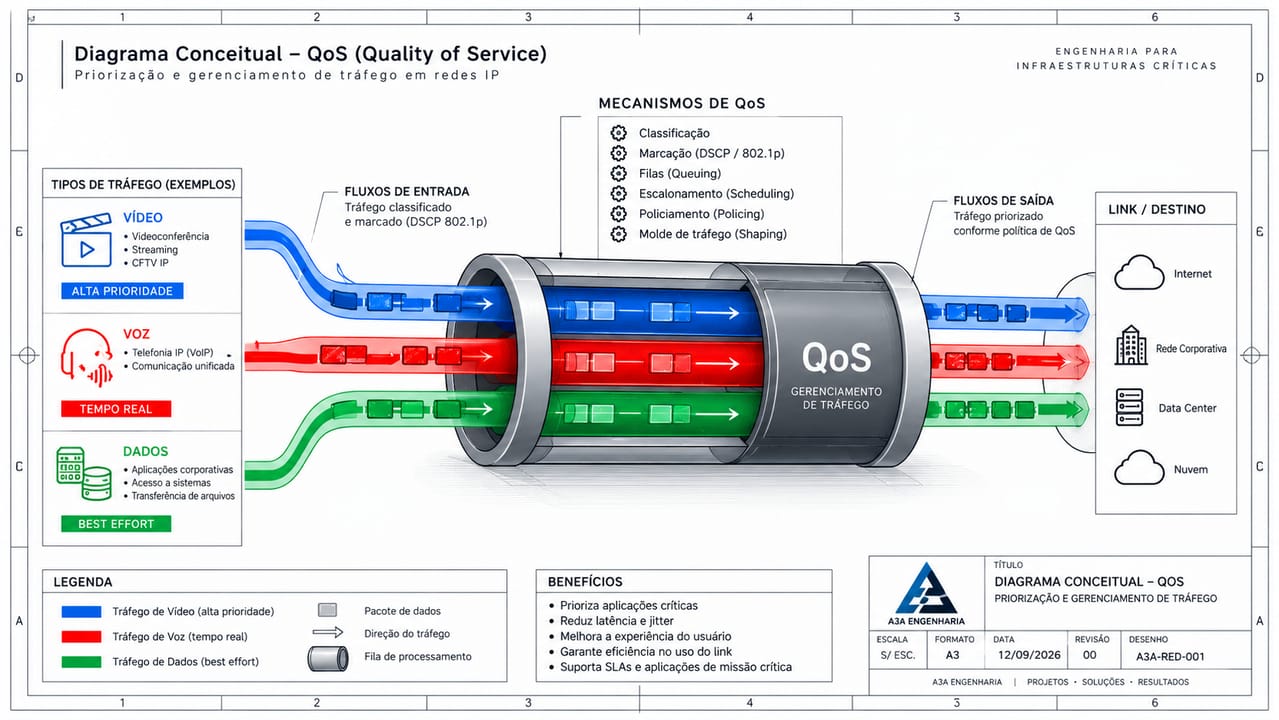
Entienda qué es QoS en redes y cómo DSCP, DiffServ, colas, shaping, policing, AQM, Wi-Fi, L4S y NQB determinan la Calidad de Servicio.
¡Descúbrelo!
QoS (Quality of Service, o Calidad de Servicio) es el conjunto de mecanismos utilizados para controlar cómo diferentes clases de tráfico compiten por recursos finitos de una red. En ingeniería, QoS incluye clasificación, marcado, acondicionamiento, encolado, planificación y control de congestión para que aplicaciones con distintos requisitos de retardo, variación de retardo, pérdida y caudal reciban tratamientos coherentes con esos requisitos.
QoS no crea ancho de banda y no significa simplemente “dar prioridad” a determinados paquetes. Una marca DSCP, por ejemplo, solo identifica una intención de tratamiento; el resultado depende de las políticas configuradas en cada dominio, de las colas disponibles, del scheduler, del estado de congestión y de la preservación — o no — de esa marca a lo largo del camino.
En la práctica, QoS se vuelve relevante cuando existe contención. En una red holgada, diferentes clases pueden presentar rendimiento similar. Cuando un enlace, radio, uplink o interfaz de salida se aproxima a la saturación, las colas pasan a determinar quién espera, quién transmite primero, quién puede consumir ancho de banda excedente y qué paquetes se descartan o señalizan antes de que el buffer se llene por completo.
Qué controla realmente QoS en una red
La Calidad de Servicio debe entenderse a partir de las características medibles del servicio, y no de una lista fija de aplicaciones “importantes”. La arquitectura DiffServ, ITU-T Y.1540/Y.1541 y la literatura clásica de redes convergen en cuatro dimensiones centrales: caudal, retardo, variación de retardo y pérdida.
| Métrica | Qué representa | Por qué importa para QoS |
| Caudal / throughput | cantidad de datos efectivamente entregada por unidad de tiempo | flujos de backup, video de alta resolución y grandes transferencias pueden exigir capacidad sostenida incluso sin necesidad de latencia extremadamente baja |
| Latencia | tiempo de tránsito entre origen y destino | aplicaciones interactivas, voz, control y determinados flujos operativos se degradan cuando aumenta el retardo |
| Jitter / IPDV | variación del retardo entre paquetes | audio y video en tiempo real dependen de regularidad de entrega; los buffers de reproducción solo pueden absorber parte de esa variación |
| Pérdida de paquetes | porción de paquetes que no llega al destino | la pérdida puede reducir la calidad de medios, provocar retransmisiones o disminuir el throughput en transportes orientados a congestión |
Estas magnitudes tienen causas diferentes. La latencia de un camino puede descomponerse, de forma simplificada, en retardo de propagación, serialización/transmisión, procesamiento y cola. QoS actúa principalmente donde existe disputa por recursos y formación de colas; no elimina la velocidad finita de propagación ni corrige por sí solo un enlace físicamente subdimensionado.
Esta distinción evita un error común: intentar “resolver con prioridad” un problema que en realidad es de capacidad, arquitectura o recorrido. El artículo sobre tráfico de red profundiza precisamente la relación entre flujos, carga y capacidad.
Latencia, jitter y pérdida no son lo mismo
Latencia é atraso. Jitter é a variação desse atraso. Uma comunicação pode ter latência relativamente alta e estável, enquanto outra apresenta latência média baixa, mas grande dispersão entre os tempos de chegada. Para aplicações interativas, os dois problemas produzem efeitos diferentes.
La pérdida también debe interpretarse en el contexto del protocolo y de la aplicación. En TCP, las pérdidas pueden inducir retransmisiones y reducir la ventana de congestión. En UDP/RTP, la aplicación puede optar por continuar sin retransmitir, privilegiando la temporalidad frente a la recuperación perfecta. Por lo tanto, la política de QoS debe definirse a partir del comportamiento real del flujo.
Por qué la congestión crea el problema que QoS debe administrar
Una interfaz de salida transmite paquetes a una tasa finita. Cuando llegan más bits de los que puede transmitir en ese intervalo, los paquetes deben esperar en memoria. Se forma una cola.
Las colas pequeñas absorben ráfagas naturales. Sin embargo, colas excesivamente profundas pueden ocultar la saturación durante un tiempo e introducir cientos de milisegundos de retardo — fenómeno asociado al bufferbloat. El problema deja de ser solo “falta de ancho de banda”: las aplicaciones interactivas pasan a compartir el mismo buffer con flujos agresivos orientados a ocupar toda la capacidad disponible.
QoS moderno, por tanto, no se limita al scheduler. Combina mecanismos de clasificación, marcado, traffic conditioning, queue scheduling, Active Queue Management (AQM) y, cuando se soporta, Explicit Congestion Notification (ECN).
Cómo funciona QoS: de la aplicación a la interfaz de salida
Un QoS eficiente comienza antes de configurar el switch: es necesario caracterizar flujos, localizar cuellos de botella, definir clases, trust boundaries, política de marcado y criterios medibles de aceptación.
A3A Engenharia estructura diseños de redes corporativas con arquitectura, capacidad, segmentación, redundancia y política de QoS documentada de extremo a extremo.
Conozca el servicio de Diseño de Red Lógica y Redes Corporativas
Un diseño coherente de QoS comienza identificando el tráfico y termina en la interfaz que realmente enfrenta contención. Entre esos puntos, la red debe mantener una política consistente.
La secuencia no implica que todos los equipos ejecuten todas las funciones. En arquitecturas DiffServ, las operaciones más complejas pueden concentrarse en los bordes del dominio, mientras el núcleo aplica Per-Hop Behaviors (PHBs) de forma escalable.
Clasificación
Clasificar es decidir a qué clase pertenece un paquete. El clasificador puede considerar origen y destino, prefijos, puertos, protocolo, VLAN, interfaz, aplicación identificada, contexto de seguridad u otros atributos disponibles en el equipo.
Una buena política prefiere criterios estables. Clasificar exclusivamente por puerto TCP/UDP, por ejemplo, se ha vuelto menos confiable en aplicaciones modernas que comparten HTTPS, QUIC o túneles. Cuando la propia aplicación marca sus paquetes, la red todavía debe definir si confía en ese marcado.
Trust boundary: dónde la red comienza a confiar en el marcado
La frontera de confianza es uno de los puntos más importantes del diseño. El marcado recibido de un endpoint no debe aceptarse automáticamente en cualquier entorno; de lo contrario, un dispositivo podría autodeclarar todo su tráfico como crítico.
En el borde, la política puede:
- confiar en el marcado de un endpoint o sistema administrado;
- reclasificar el flujo según una política local;
- remarcar DSCP/PCP a los valores internos del dominio;
- limitar o aplicar policing a clases con recursos reservados;
- eliminar marcas no autorizadas.
Esta decisión forma parte de la seguridad y de la gobernanza de recursos de la red, no solo del rendimiento.
DSCP, DS Field y por qué el marcado no es prioridad automática
El Differentiated Services Code Point (DSCP) ocupa seis bits del campo DS en el encabezado IP. Los dos bits restantes del octeto se utilizan para ECN. El DSCP selecciona el comportamiento que la red pretende asociar al paquete dentro de un dominio DiffServ.
Es incorrecto tratar el valor decimal del DSCP como una escala universal en la que “cuanto mayor, mayor prioridad”. Los codepoints representan semánticas definidas por estándares o políticas de dominio. El tratamiento solo existe si los nodos están configurados para mapear ese codepoint al PHB y a los mecanismos de cola correspondientes.
Del mismo modo, marcar no reserva ancho de banda. Un paquete EF no recibe mágicamente baja latencia por contener determinado patrón de bits; la red debe aprovisionar capacidad, limitar la admisión a la clase y configurar un comportamiento de reenvío compatible.
DSCP vs. PCP/CoS en Ethernet
En redes Ethernet con VLAN, IEEE 802.1Q proporciona el campo Priority Code Point (PCP) de tres bits en la etiqueta VLAN. Esto permite representar ocho valores de prioridad de usuario en el dominio de capa 2.
DSCP y PCP operan en capas diferentes:
- DSCP: marcado de capa 3 en el encabezado IPv4/IPv6;
- PCP: información de prioridad asociada a la etiqueta IEEE 802.1Q en capa 2;
- mapeo entre ambos: política del dominio, no equivalencia automática.
Al cruzar fronteras L2/L3, túneles o dominios administrativos, la ingeniería debe definir explícitamente qué se preserva, traduce o elimina.
DiffServ: la arquitectura más importante para QoS IP escalable
La arquitectura Differentiated Services (DiffServ) fue concebida para proporcionar diferenciación de servicio de forma escalable. El tráfico se clasifica y acondiciona en los bordes, se marca en el campo DS y se agrega en clases de comportamiento. En el núcleo, cada paquete recibe un Per-Hop Behavior asociado a su DSCP.
Esta idea resuelve una limitación de las arquitecturas basadas en estado por flujo: el core no necesita mantener una reserva individual para cada sesión. Trata agregados.
PHB: el tratamiento que un nodo aplica por salto
Un PHB describe el comportamiento observable que un agregado recibe en un nodo. Esto es diferente de prometer un resultado end-to-end. La experiencia extremo a extremo resulta de la composición de todos los saltos y dominios atravesados.
| PHB / tratamiento | Finalidad | Observación de ingeniería |
| Default / Best Effort | servicio estándar de Internet | adecuado para tráfico sin requisitos especiales; no significa “tráfico malo” |
| EF — Expedited Forwarding | base para servicios de bajo retardo, bajo jitter y baja pérdida | depende de la tasa configurada y del control de admisión/acondicionamiento; no debe convertirse en una cola ilimitada de “todo lo importante” |
| AF — Assured Forwarding | cuatro clases con diferentes recursos y tres niveles de precedencia de descarte en cada clase | útil cuando se desea diferenciar la probabilidad de reenvío bajo congestión |
| LE — Lower Effort | tráfico que puede ceder recursos a Best Effort durante congestión | apropiado para servicios de menor urgencia, como determinadas sincronizaciones y transferencias oportunistas |
| NQB — Non-Queue-Building | aislar microflujos suaves, de baja tasa y no formadores de cola del tráfico que crea colas profundas | PHB reciente; no ofrece capacidad reservada ni “alta prioridad” |
La RFC 4594 organiza clases de servicio a partir de las características de las aplicaciones y de sus requisitos de desempeño. El documento presenta un conjunto amplio de clases de referencia, pero no recomienda que toda red implemente todas ellas. En la práctica, menos clases, bien definidas y medibles, suelen producir políticas más robustas que decenas de clases difíciles de operar.
EF no es sinónimo de voz ni AF es sinónimo de video
Estas asociaciones aparecen en muchos ejemplos de fabricantes, pero el diseño debe partir del requisito. Un flujo de señalización de control puede merecer tratamiento diferente de un flujo de medios; el video grabado para almacenamiento puede tolerar retardo de cola que una videoconferencia no tolera; el tráfico de cámaras puede requerir alto throughput sin exigir un tratamiento de baja latencia equivalente al de la voz interactiva.
El PHB debe elegirse por la ingeniería de la clase, no por el nombre de la aplicación.
Colas y schedulers: quién transmite cuando existe contención
Después de la clasificación, los paquetes normalmente se asocian a colas de salida. El scheduler decide en qué orden y en qué proporción esas colas utilizan la interfaz.
Los nombres exactos varían según la plataforma, pero los modelos conceptuales más comunes incluyen FIFO, prioridad estricta y algoritmos de compartición ponderada como WFQ, WRR/DRR y variantes implementadas comercialmente.
FIFO
En First In, First Out, todos los paquetes comparten una cola y salen en orden de llegada. Es simple, pero no diferencia clases. Un flujo grande puede aumentar el retardo experimentado por un pequeño flujo interactivo.
Prioridad estricta
Una cola de prioridad estricta puede atenderse antes que las demás. Es útil para tráfico con requisitos rigurosos, pero exige protección contra starvation: si la clase prioritaria puede ocupar indefinidamente la interfaz, las otras clases pueden quedarse sin servicio suficiente.
Por ello, las clases prioritarias deben dimensionarse y controlarse. “Marcar más cosas como prioritarias” tiende a destruir el propio beneficio de la prioridad.
Compartición ponderada
Los schedulers ponderados distribuyen capacidad entre clases según pesos, garantías mínimas o políticas equivalentes. Son útiles para clases que necesitan participación predecible bajo congestión, pero pueden aprovechar ancho de banda excedente cuando otras colas están vacías.
Un diseño común combina una cola estricta limitada para tráfico realmente sensible al tiempo con colas ponderadas para las demás clases. El principio es más importante que el nombre comercial del mecanismo.
Shaping vs. policing: dos mecanismos que no deben confundirse
Traffic shaping y traffic policing controlan la tasa, pero lo hacen de maneras diferentes.
| Mecanismo | Acción cuando el tráfico excede el perfil | Efecto típico |
| Shaping | retiene temporalmente paquetes y suaviza la tasa de salida | añade cola y retardo controlado para adecuar el flujo a una tasa configurada |
| Policing | identifica tráfico fuera del perfil y puede descartar o remarcar paquetes | limita el uso del recurso sin crear una cola de espera equivalente al shaping |
Shaping es especialmente útil antes de un cuello de botella cuya tasa efectiva es menor que la velocidad física de la interfaz local, porque permite que el equipo forme la cola en un punto donde posee control de QoS.
Policing es útil en fronteras contractuales o para proteger clases. Sin embargo, descartar agresivamente tráfico orientado a TCP puede reducir el throughput y generar ciclos de retransmisión. La política debe considerar el comportamiento del transporte.
Token bucket, srTCM y trTCM
Muchos conditioners se explican mediante modelos de token bucket. Los tokens representan permiso para transmitir una cantidad de bytes; se acumulan según una tasa y están limitados por un tamaño de burst.
La RFC 2697 define el Single Rate Three Color Marker (srTCM), basado en CIR, CBS y EBS. La RFC 2698 define el Two Rate Three Color Marker (trTCM), que añade una tasa pico. Estos modelos permiten distinguir tráfico dentro del perfil, excedente y claramente fuera del perfil, habilitando políticas de AF y policing más refinadas que un simple “pasa o descarta”.
AQM, ECN y bufferbloat: QoS también consiste en controlar la cola antes de que desborde
En una cola tradicional con tail drop, los paquetes solo se descartan cuando el buffer alcanza su límite. Este comportamiento puede mantener colas persistentemente llenas e introducir un retardo elevado.
Active Queue Management (AQM) intenta detectar congestión antes del desbordamiento completo y señalizarla mediante descarte o, cuando ECN es compatible, mediante marcado explícito. La RFC 7567 recomienda fuertemente el uso de AQM como parte de la preservación del rendimiento de Internet.
RED/WRED, CoDel y FQ-CoDel
RED y sus derivados introdujeron la idea de descarte probabilístico anticipado. Las implementaciones WRED también pueden asociar diferentes perfiles de descarte a clases o precedencias.
CoDel, descrito en la RFC 8289 como Experimental, utiliza el tiempo de permanencia del paquete en la cola (sojourn time) para controlar el exceso de retardo asociado al bufferbloat. FQ-CoDel, RFC 8290, combina separación de flujos con AQM, reduciendo la capacidad de un flujo pesado para aumentar la latencia de todos los demás.
Estos mecanismos muestran una evolución importante: la calidad percibida no depende solo del orden de salida de las clases; también depende de cuánto tiempo permite la red que crezca la cola.
ECN: señalizar congestión sin necesariamente descartar
La RFC 3168 introdujo Explicit Congestion Notification en IP/TCP. En lugar de señalizar congestión exclusivamente mediante pérdida, un nodo AQM puede marcar paquetes ECN-capable, permitiendo que los endpoints reaccionen a la congestión.
ECN no elimina la necesidad de colas y control de congestión. Añade una forma explícita de señalización entre red y transporte. Enfoques modernos de baja latencia, como L4S, amplían este concepto.
IntServ y RSVP: reserva por flujo y diferencia frente a DiffServ
Antes de la consolidación de DiffServ como principal arquitectura escalable de diferenciación, la IETF desarrolló el modelo Integrated Services (IntServ). La idea es permitir que las aplicaciones soliciten recursos y que los nodos mantengan estado asociado a los flujos.
RSVP, definido en la RFC 2205, es un protocolo de señalización de reservas para flujos unicast o multicast. Combinado con IntServ, permite admission control y tratamiento basado en requisitos explícitos.
La diferencia arquitectónica es fundamental:
- IntServ/RSVP trabaja con estado y reserva por flujo;
- DiffServ agrega tráfico en clases y aplica PHBs escalables por dominio.
IntServ sigue siendo conceptualmente importante y RSVP tiene usos específicos, pero mantener estado por flujo en grandes redes impone desafíos de escalabilidad y operación. En redes corporativas, campus, WAN y proveedores, DiffServ suele ser la base más común de las políticas de QoS.
QoS en Ethernet: IEEE 802.1Q y clases de tráfico
IEEE 802.1Q es la referencia central para bridges y redes bridged, incluidas VLANs y mecanismos asociados a prioridades de usuario. En una red con etiquetas VLAN, PCP permite transportar una indicación de prioridad en el dominio Ethernet.
Esto no convierte Ethernet en un dominio automáticamente alineado con IP. Un diseño debe definir el mapeo DSCP ↔ PCP ↔ colas de hardware en cada tipo de switch, además de identificar situaciones en las que la etiqueta VLAN se elimina, añade o modifica.
En redes convergentes, la coherencia entre capas evita comportamientos paradójicos: un paquete puede estar marcado como crítico en IP, pero entrar en una cola Best Effort en capa 2 si no existe una política de traducción adecuada.
QoS en Wi‑Fi: EDCA, Access Categories y mapeo de DiffServ
En WLAN, el medio es compartido y el problema cambia: además de las colas en los equipos, las estaciones compiten por el acceso al radio. IEEE 802.11-2024 consolida los mecanismos MAC/PHY actuales, incluidos los mecanismos de QoS incorporados al estándar a lo largo de sus revisiones.
El modelo EDCA utiliza cuatro Access Categories:
- AC_VO — Voice;
- AC_VI — Video;
- AC_BE — Best Effort;
- AC_BK — Background.
Estas categorías alteran estadísticamente la oportunidad de acceso al medio. Por tanto, traducir DSCP directamente a una Access Category exige cuidado: una marca creada para un comportamiento en IP puede producir una prioridad diferente cuando se interpreta en Wi‑Fi.
La RFC 8325 ofrece recomendaciones para mapear clases DiffServ en IEEE 802.11. La ingeniería debe utilizar este mapeo conscientemente, especialmente en redes corporativas densas. Para cobertura, capacidad, roaming y comportamiento de radio, consulte también el servicio de Diseño de Red Wi‑Fi Corporativa.
NQB hizo aún más interesante el mapeo Wi‑Fi
La RFC 9956, publicada durante 2026, actualiza la orientación de la RFC 8325 para el nuevo NQB PHB. El DSCP recomendado para NQB es 45 decimal. La particularidad es que NQB no representa “alta prioridad”: representa tráfico de baja tasa y no formador de cola que debe aislarse de flujos que crean colas persistentes.
En equipos Wi‑Fi plenamente compatibles con la recomendación NQB, la intención es mantener NQB en una cola separada con preferencia de reenvío equivalente a Best Effort. En equipos legados, DSCP 45 puede caer en mapeos que lo tratan como video, razón por la cual la RFC discute explícitamente interoperabilidad, remarcado y protección contra uso indebido.
Este es un buen ejemplo de por qué leer DSCP como un simple número de prioridad es técnicamente incorrecto.
QoS en WAN, MPLS, SD-WAN, túneles y múltiples dominios
Dentro de un único campus, la organización controla casi todo el camino. En WAN y conexiones con proveedores, la política atraviesa fronteras administrativas.
Un paquete puede salir del campus marcado, atravesar un túnel, recibir otro encabezado, entrar en una red MPLS, pasar por una Internet pública que borra DSCP y llegar a un destino donde la marca original ya no existe. Por ello, QoS end-to-end exige distinguir intención local de tratamiento contratado entre dominios.
Los puntos de diseño incluyen:
- qué DSCP acepta el proveedor;
- cómo se mapean las clases a la oferta WAN;
- dónde ocurre remarking o DSCP bleaching;
- cómo los túneles copian o no información de QoS entre encabezados interno y externo;
- dónde está el cuello de botella real;
- qué tasa debe utilizar el shaper cuando la interfaz física es más rápida que el servicio contratado;
- cómo las rutas alternativas mantienen una política equivalente.
En SD-WAN, la selección dinámica de camino puede complementar QoS: un flujo sensible puede dirigirse a un enlace que cumpla mejor sus requisitos de pérdida, latencia y jitter. Esto no sustituye la gestión de colas en el cuello de botella.
QoS para voz, videoconferencia, CFTV y aplicaciones corporativas
Una política madura separa requisitos de servicio de etiquetas de aplicación.
Voz y comunicaciones interactivas
La voz conversacional es sensible a retardo, jitter y pérdida. ITU-T G.114 trata el impacto del retardo unidireccional en la calidad conversacional y recuerda que las tareas altamente interactivas pueden verse afectadas mucho antes de límites extremos de retardo.
Para voz, el volumen de tráfico suele ser relativamente pequeño y predecible, lo que hace viable una clase de baja latencia bien dimensionada. Sin embargo, señalización, medios y servicios auxiliares no necesitan recibir necesariamente exactamente el mismo PHB.
El Diseño de Telefonía IP y Comunicaciones Unificadas debe integrar codec, capacidad, arquitectura, señalización y política de QoS, en lugar de tratar QoS como una configuración aislada del switch.
Videoconferencia y AV over IP
La videoconferencia combina audio sensible al retardo con video que demanda más ancho de banda y puede adaptar el bitrate. AV over IP también puede utilizar multicast, sincronismo y flujos de altísima tasa.
Colocar todo este tráfico en una cola de prioridad estricta es una solución simplista. La política debe reservar baja latencia donde realmente sea necesaria y garantizar capacidad a las clases de medios sin permitir que una ráfaga extensa monopolice la interfaz.
CFTV IP: la prioridad máxima no siempre es la respuesta correcta
En CFTV IP, el tráfico de video no debe clasificarse automáticamente como de máxima prioridad. La política de QoS debe distinguir los flujos según sensibilidad a retardo y jitter, necesidad de throughput sostenido, criticidad operacional y consecuencia de la pérdida.
Un sistema de CFTV puede tener flujos diferentes:
| Flujo | Característica predominante | Tratamiento posible |
| stream de grabación cámara → VMS/NVR | throughput sostenido y predecible; alta agregación | clase con ancho de banda suficiente y protección contra congestión, sin usar necesariamente prioridad estricta |
| live view operativo | sensible a retardo/jitter en operación en tiempo real | puede justificar una clase distinta del tráfico de grabación |
| PTZ y comandos de control | baja tasa, alta interactividad | una clase de control separada puede ser más importante que priorizar todo el video |
| exportación de evidencia / backup | gran cantidad de datos, baja urgencia relativa | candidato a clase Best Effort o Lower Effort según la política |
| analytics distribuido | el perfil depende de la arquitectura: metadatos, video o ambos | clasificar por el flujo real y la consecuencia operacional |
La política de QoS para CFTV debe definirse a partir del bitrate agregado, oversubscription, topología, uso de multicast o unicast, redundancia, arquitectura de almacenamiento y criticidad operacional. El artículo sobre cableado de red para CFTV IP complementa la capa física y de acceso de este problema.
QoS end-to-end: una marca aislada no garantiza calidad
La expresión end-to-end QoS solo tiene sentido cuando la política se analiza a lo largo de todo el camino relevante. Un paquete puede recibir un tratamiento excelente en nueve saltos y sufrir congestión severa en el décimo. El resultado de la aplicación estará determinado por el cuello de botella.
Esto exige una visión de arquitectura. La Arquitectura de Red Corporativa define los dominios, caminos y puntos de agregación sobre los cuales se aplicará la política de QoS.
Método de diseño recomendado
- Levantar aplicaciones y flujos. Identificar origen, destino, protocolo, dirección, tasa media, pico, burst y criticidad.
- Definir requisitos medibles. Establecer qué importa realmente para cada clase: retardo, IPDV/jitter, pérdida, throughput o disponibilidad.
- Localizar cuellos de botella. Mapear uplinks, enlaces WAN, radios, interfaces con oversubscription y servicios contratados por debajo de la velocidad física.
- Definir pocas clases de servicio. Agrupar aplicaciones con características similares, evitando una clase por aplicación.
- Definir trust boundaries. Determinar quién puede marcar, dónde confía la red y dónde remarca.
- Elegir PHBs y colas. Asociar cada clase a un tratamiento coherente: prioridad limitada, compartición ponderada, Best Effort, Lower Effort o NQB cuando corresponda.
- Aplicar shaping/policing. Acondicionar tráfico en los bordes y formar la cola antes del cuello de botella cuando sea necesario.
- Definir AQM/ECN. Controlar colas profundas y permitir señalización de congestión cuando endpoints y equipos lo soporten.
- Mapear entre tecnologías. Documentar DSCP, PCP, Access Category Wi‑Fi, clases WAN/MPLS y comportamiento en túneles.
- Probar bajo congestión. QoS debe validarse cuando existe contención; probar solo en una red ociosa no demuestra la política.
- Monitorear y revisar. Contrastar la política con telemetría real y cambios en las aplicaciones.
Un Diseño de Red Lógica y Redes Corporativas debe registrar esta política como parte de la arquitectura y la documentación técnica, no como una colección de comandos específicos de fabricante.
Cómo validar si QoS está funcionando
La validación debe observar tanto la configuración como el comportamiento. Ver un DSCP en el paquete confirma el marcado, pero no demuestra que el paquete haya recibido el tratamiento previsto.
Los indicadores relevantes incluyen:
- utilización por interfaz y por clase;
- tasa de colas y ocupación de buffers;
- drops por clase y causa;
- marcas ECN cuando corresponda;
- throughput entregado;
- latencia, jitter/IPDV y pérdida extremo a extremo;
- policer drops y tráfico fuera de perfil;
- cambios de DSCP al atravesar fronteras;
- distribución de flujos que consumen cada clase.
La telemetría de flujos ayuda a descubrir quién está ocupando la red. El artículo NetFlow: qué es, cómo funciona y cómo analizar tráfico de red detalla este nivel de observabilidad. El Gestión de Redes basada en FCAPS y SNMP amplía la visión hacia la operación continua.
Prueba en condiciones controladas
La política debe someterse a tráfico concurrente suficiente para crear contención controlada. Luego se mide si la clase sensible mantiene los objetivos esperados y si las demás clases continúan recibiendo servicio adecuado.
Una política que solo funciona porque el enlace nunca supera el 20% de utilización no ha sido validada efectivamente como QoS; simplemente no ha encontrado congestión.
QoS moderno: L4S y NQB muestran que “prioridad” es una visión incompleta
Dos evoluciones recientes ayudan a comprender la dirección actual del tema.
L4S: baja latencia con congestion control escalable y ECN
La arquitectura L4S — Low Latency, Low Loss and Scalable Throughput, descrita en la RFC 9330, busca reducir drásticamente el retardo de cola combinando controles de congestión escalables en los endpoints, señalización ECN más frecuente y AQM compatible en el cuello de botella.
El punto conceptual es importante: la propia RFC resalta que la baja latencia no surge simplemente porque la red “prioriza” un paquete. Depende del comportamiento del congestion control del emisor y de un feedback de congestión más preciso, con mecanismos de red que separan tráfico L4S del comportamiento Classic.
L4S no sustituye DiffServ. Son mecanismos que atacan problemas relacionados desde ángulos diferentes: DiffServ diferencia clases/PHBs; L4S modifica la relación entre cola, AQM, ECN y control de congestión.
NQB: baja cola sin reservar capacidad
El Non-Queue-Building PHB, RFC 9956, fue estandarizado para microflujos suaves, de baja tasa y limitados por la propia aplicación que no contribuyen materialmente a la formación de colas.
NQB proporciona una cola poco profunda separada del Best Effort profundo, pero no ofrece ancho de banda reservado y no debe recibir preferencia de reenvío superior a Default. Su beneficio proviene del aislamiento respecto de los flujos que construyen colas, no de saltarse la cola por prioridad.
Esto abre espacio para aplicaciones interactivas de baja tasa, IoT, determinados flujos de control y otros microflujos que sufren bufferbloat incluso sin consumir ancho de banda significativo. Como cualquier PHB, su adopción exige soporte de los nodos relevantes y una política coherente de marcado y protección.
Errores comunes en diseños de QoS
Marcar todo como alta prioridad
Cuando muchas aplicaciones reciben la clase más privilegiada, esa clase pasa a competir consigo misma. La red deja de poder diferenciar lo que realmente necesita baja latencia.
Copiar una tabla DSCP sin analizar el tráfico
Las tablas de referencia son útiles, pero no sustituyen la caracterización. El mismo tipo nominal de aplicación puede tener perfiles completamente diferentes según codec, resolución, arquitectura y dirección del flujo.
Configurar QoS solo en el core
La congestión suele aparecer en interfaces de salida, accesos, WAN, Wi‑Fi y puntos de agregación. Una política impecable en el core puede ser irrelevante si el cuello de botella está en el borde.
Confiar ciegamente en el marcado del endpoint
QoS también es una política de autorización de consumo de recursos. Los trust boundaries deben ser explícitos.
Ignorar la tasa contratada del proveedor
Una interfaz de 1 Gb/s conectada a un servicio WAN de 200 Mb/s no necesariamente ve el cuello de botella en el lugar esperado. Sin shaping próximo a la tasa real, la cola puede formarse en la red del proveedor, fuera del control local.
Confundir QoS con capacidad
QoS administra escasez; no corrige subdimensionamiento estructural. Si la suma de los servicios esenciales supera continuamente la capacidad disponible, es necesario revisar arquitectura y bandwidth.
Consideraciones finales
QoS es una disciplina de ingeniería de tráfico y gestión de colas, no un botón de prioridad. Un diseño consistente parte de los requisitos de las aplicaciones, mide la red, define pocas clases, establece fronteras de confianza, elige PHBs y mecanismos de cola adecuados, acondiciona el tráfico donde sea necesario y valida el resultado bajo congestión real.
DiffServ y DSCP continúan siendo la base para la diferenciación escalable en redes IP; IEEE 802.1Q e IEEE 802.11 determinan cómo esa intención encuentra los dominios Ethernet y Wi‑Fi; AQM y ECN tratan la dinámica de las colas; IntServ/RSVP explican la alternativa basada en reserva por flujo; y mecanismos recientes como L4S y NQB muestran que la baja latencia moderna depende cada vez menos de una noción simplista de “prioridad máxima”.
El resultado buscado no es tener paquetes con números diferentes en el encabezado. Es obtener comportamiento medible, predecible y documentado para los servicios que comparten la infraestructura.
Una política de QoS debe probarse bajo congestión controlada. Un marcado correcto sin comportamiento medible en las colas no demuestra calidad de servicio.
En redes críticas, el diseño debe transformar requisitos de latencia, jitter, pérdida y throughput en criterios de configuración, comisionamiento y monitoreo.
Vea cómo estructuramos diseños de redes y telecomunicaciones
Referencias técnicas
[1] NICHOLS, K.; BLAKE, S.; BAKER, F.; BLACK, D.. RFC 2474 — Definition of the Differentiated Services Field (DS Field) in the IPv4 and IPv6 Headers. 1998. Disponible en: https://www.rfc-editor.org/info/rfc2474/.
[2] BLAKE, S. et al.. RFC 2475 — An Architecture for Differentiated Services. 1998. Disponible en: https://www.rfc-editor.org/info/rfc2475/.
[3] HEINANEN, J. et al.. RFC 2597 — Assured Forwarding PHB Group. 1999. Disponible en: https://www.rfc-editor.org/info/rfc2597/.
[4] DAVIE, B. et al.. RFC 3246 — An Expedited Forwarding PHB (Per-Hop Behavior). 2002. Disponible en: https://www.rfc-editor.org/info/rfc3246/.
[5] GROSSMAN, D.. RFC 3260 — New Terminology and Clarifications for Diffserv. 2002. Disponible en: https://www.rfc-editor.org/info/rfc3260/.
[6] BABIARZ, J.; CHAN, K.; BAKER, F.. RFC 4594 — Configuration Guidelines for DiffServ Service Classes. 2006. Disponible en: https://www.rfc-editor.org/info/rfc4594/.
[7] HEINANEN, J.; GUERIN, R.. RFC 2697 — A Single Rate Three Color Marker. 1999. Disponible en: https://www.rfc-editor.org/info/rfc2697/.
[8] HEINANEN, J.; GUERIN, R.. RFC 2698 — A Two Rate Three Color Marker. 1999. Disponible en: https://www.rfc-editor.org/info/rfc2698/.
[9] RAMAKRISHNAN, K.; FLOYD, S.; BLACK, D.. RFC 3168 — The Addition of Explicit Congestion Notification (ECN) to IP. 2001. Disponible en: https://www.rfc-editor.org/info/rfc3168/.
[10] BAKER, F.; FAIRHURST, G.. RFC 7567 / BCP 197 — IETF Recommendations Regarding Active Queue Management. 2015. Disponible en: https://www.rfc-editor.org/info/rfc7567/.
[11] NICHOLS, K. et al.. RFC 8289 — Controlled Delay Active Queue Management. 2018. Disponible en: https://www.rfc-editor.org/info/rfc8289/.
[12] HOILAND-JORGENSEN, T. et al.. RFC 8290 — The Flow Queue CoDel Packet Scheduler and Active Queue Management Algorithm. 2018. Disponible en: https://www.rfc-editor.org/info/rfc8290/.
[13] SARKAR, S. et al.. RFC 8325 — Mapping Diffserv to IEEE 802.11. 2018. Disponible en: https://www.rfc-editor.org/info/rfc8325/.
[14] BLESS, R.. RFC 8622 — A Lower-Effort Per-Hop Behavior (LE PHB) for Differentiated Services. 2019. Disponible en: https://www.rfc-editor.org/info/rfc8622/.
[15] BRISCOE, B. et al.. RFC 9330 — Low Latency, Low Loss, and Scalable Throughput (L4S) Internet Service: Architecture. 2023. Disponible en: https://www.rfc-editor.org/info/rfc9330/.
[16] WHITE, G.; FOSSATI, T.; GEIB, R.. RFC 9956 — A Non-Queue-Building Per-Hop Behavior (NQB PHB) for Differentiated Services. 2026. Disponible en: https://www.rfc-editor.org/info/rfc9956/.
[17] BRADEN, R.; CLARK, D.; SHENKER, S.. RFC 1633 — Integrated Services in the Internet Architecture: an Overview. 1994. Disponible en: https://www.rfc-editor.org/info/rfc1633/.
[18] BRADEN, R. et al.. RFC 2205 — Resource ReSerVation Protocol (RSVP) — Version 1 Functional Specification. 1997. Disponible en: https://www.rfc-editor.org/info/rfc2205/.
[19] IEEE. IEEE Std 802.1Q-2022 — IEEE Standard for Local and Metropolitan Area Networks — Bridges and Bridged Networks. 2022. Disponible en: https://standards.ieee.org/ieee/802.1Q/10323/.
[20] IEEE. IEEE Std 802.11-2024 — Wireless LAN Medium Access Control (MAC) and Physical Layer (PHY) Specifications. 2024. Disponible en: https://standards.ieee.org/ieee/802.11/10548/.
[21] ITU-T. Recommendation Y.1540 — Internet protocol data communication service — IP packet transfer and availability performance parameters. 2019. Disponible en: https://www.itu.int/rec/T-REC-Y.1540/.
[22] ITU-T. Recommendation Y.1541 — Network performance objectives for IP-based services. 2011. Disponible en: https://www.itu.int/rec/T-REC-Y.1541/.
[23] ITU-T. Recommendation G.114 — One-way transmission time. 2003. Disponible en: https://www.itu.int/rec/T-REC-G.114/.
[24] OPPENHEIMER, P.. Top-Down Network Design. 3. ed. Indianapolis: Cisco Press. 2011.
[25] TANENBAUM, A. S.; WETHERALL, D. J.. Computer Networks. 5. ed. Boston: Pearson. 2011.
Preguntas frecuentes
QoS significa Quality of Service, o Calidad de Servicio. Es el conjunto de mecanismos utilizado para clasificar y tratar diferentes clases de tráfico según requisitos de retardo, jitter, pérdida y caudal.
No. QoS no crea capacidad. Administra cómo se comparte la capacidad existente cuando hay contención, pudiendo reducir retardo o pérdida para determinadas clases a costa de un tratamiento diferente para otras.
No de forma universal. DSCP es un codepoint en el campo DS del encabezado IP que selecciona una intención de Per-Hop Behavior dentro de un dominio DiffServ. El tratamiento depende de la política configurada en los equipos.
Shaping retiene paquetes en cola para suavizar la tasa de salida; policing mide el tráfico contra un perfil y puede remarcar o descartar el excedente. El primero introduce retardo controlado, mientras el segundo limita el uso del recurso sin formar la misma cola de espera.
EF es un PHB utilizado como bloque para servicios de bajo retardo, jitter y pérdida cuando la clase está adecuadamente aprovisionada. AF define cuatro clases independientes y tres niveles de precedencia de descarte dentro de cada clase, permitiendo diferentes probabilidades de entrega bajo congestión.
No. La grabación continua, live view, PTZ, analytics y exportación tienen perfiles diferentes. El diseño debe separar los flujos y definir el tratamiento según necesidades de latencia, pérdida y throughput, evitando colocar todo el video en una cola de prioridad estricta.
En Wi‑Fi, además de las colas del equipo, existe disputa por el medio radioeléctrico. IEEE 802.11 utiliza Access Categories como Voice, Video, Best Effort y Background. El mapeo entre DSCP y estas categorías debe diseñarse; la RFC 8325 proporciona orientaciones específicas.
NQB es el Non-Queue-Building PHB estandarizado por la RFC 9956 durante 2026. Utiliza una cola poco profunda separada para microflujos suaves y de baja tasa que no forman colas. No ofrece ancho de banda reservado ni prioridad superior a Best Effort; el DSCP recomendado es 45 decimal.
Es la ingeniería del tratamiento del tráfico a lo largo de todos los dominios relevantes, incluidos LAN, Wi‑Fi, WAN, túneles y redes de proveedores. Un marcado aislado en un único equipo no garantiza rendimiento extremo a extremo.
Materiales técnicos complementarios
Servicios relacionados
- Diseño de Red Lógica y Redes Corporativas: arquitectura, redundancia, segmentación y seguridad
- Diseño de Red Wi‑Fi Corporativa: cobertura, capacidad, roaming y seguridad
- Diseño de Telefonía IP y Comunicaciones Unificadas: SIP, numeración, QoS e integración
Soluciones relacionadas
Contenidos principales sobre el tema
- Diseño de Red: etapas, arquitectura y documentación técnica
- Arquitectura de Red Corporativa: capas, modelos y criterios de diseño
- Guía Completa sobre Arquitectura de Redes: topologías, diseño e infraestructura
Contenidos técnicos relacionados
- Tráfico de Red: flujos, carga, broadcast, multicast y capacidad
- NetFlow: qué es, cómo funciona y cómo analizar tráfico de red
- Gestión de Redes: FCAPS, SNMP, configuración, rendimiento y seguridad
- Protocolo RTP: qué es y cómo transporta audio y video en tiempo real
- Protocolo TCP: qué es, cómo funciona y diferencias frente a UDP
- Protocolo UDP: qué es, cómo funciona y cuándo usar
