Guía técnica de troubleshooting de redes: diagnóstico por capas, cableado, PoE, switching, VLANs, DHCP, DNS, firewall, Wi-Fi, WAN, causa raíz y corrección.
¡Descúbrelo!
El troubleshooting de redes es el proceso estructurado de identificar, aislar y corregir fallas de conectividad, disponibilidad o rendimiento con base en evidencias. El objetivo no es probar comandos al azar ni sustituir equipos por ensayo y error. Consiste en reducir el dominio de falla, formular hipótesis, medir el comportamiento de la red y demostrar la causa raíz antes de aplicar la corrección.
Una falla percibida como “la red está lenta” puede originarse en el cableado, en un puerto de switch, en PoE, en un uplink saturado, en Wi-Fi, en una VLAN, en el enrutamiento, en DNS, en DHCP, en el firewall, en el enlace WAN, en el servidor o en la aplicación. Por ello, un troubleshooting eficiente separa síntoma, causa e impacto y recorre la cadena de comunicación de forma disciplinada.
¿Qué es el troubleshooting de redes?
El troubleshooting es una actividad de diagnóstico técnico. En redes pequeñas, muchos incidentes pueden resolverse por un equipo interno con herramientas básicas. En entornos corporativos, industriales o críticos, sin embargo, la cantidad de capas, proveedores, dependencias y caminos exige trabajar con topología, documentación, métricas, logs e instrumentos de prueba.
La diferencia entre una corrección puntual y un diagnóstico de ingeniería está en la trazabilidad. Una corrección puntual puede restablecer el servicio; un diagnóstico de ingeniería debe explicar qué falló, por qué falló, cómo se comprobó, qué corrección se aplicó y cómo evitar la recurrencia.
Un síntoma no es la causa raíz
Los usuarios describen efectos: lentitud, caídas, video congelado, teléfono sin audio, cámara offline, página que no abre, autenticación que falla. Estos relatos son importantes, pero todavía no localizan el problema.
Algunos ejemplos muestran la diferencia:
| Síntoma | Causas posibles |
| estación sin acceso | cable, puerto, VLAN, DHCP, autenticación, gateway, DNS |
| AP reiniciándose | PoE, fuente del switch, cable, firmware, temperatura |
| videoconferencia inestable | Wi-Fi, uplink, pérdida, jitter, WAN, firewall, aplicación |
| cámara intermitente | canal físico, PoE, switch, uplink, VMS, energía |
| transferencia lenta | negociación, errores de interfaz, saturación, storage, servidor |
| varios sectores fuera de servicio | switch, uplink, core, energía, enrutamiento, servicio común |
Cambiar un patch cord puede resolver un síntoma, pero si el defecto es una terminación marginal en el enlace permanente, la falla tenderá a regresar.
Primer paso: delimitar el dominio de falla
El diagnóstico comienza definiendo el alcance del problema.
Preguntas simples reducen drásticamente el campo de investigación:
- ¿afecta a un usuario, una sala, un switch, un piso o toda la organización?
- ¿afecta a usuarios cableados y wireless o solo a un medio?
- ¿afecta a todos los servicios o solo a una aplicación?
- ¿comenzó después de un cambio?
- ¿ocurre continuamente o en horarios específicos?
- ¿coincide con picos de utilización?
- ¿existe correlación con energía, temperatura o eventos de infraestructura?
- ¿todos los dispositivos afectados comparten algún switch, uplink, VLAN, gateway o servicio?
Cuando varias fallas comparten un elemento común, ese elemento se convierte en candidato prioritario. Este razonamiento evita iniciar el análisis por el punto más visible pero técnicamente improbable.
Antes de modificar, recopile evidencias
Modificar la configuración durante el diagnóstico puede destruir la evidencia que permitiría localizar la causa. Antes de reiniciar un switch, cambiar una ruta, mover una VLAN o sustituir un equipo, registre el estado.
Según el incidente, la recopilación puede incluir:
- hora de inicio y duración;
- usuarios y sistemas afectados;
- topología del camino;
- estado y velocidad de las interfaces;
- contadores de errores y descartes;
- utilización de CPU y memoria;
- utilización de uplinks;
- logs del sistema;
- eventos de spanning tree y LACP;
- estado de PoE;
- leases DHCP;
- consultas y respuestas DNS;
- latencia y pérdida en diferentes saltos;
- potencia y calidad de señal Wi-Fi;
- alertas del firewall y enlaces WAN;
- cambios recientes.
Un snapshot del estado previo al incidente también ayuda a comparar comportamiento normal y anormal.
Baseline: saber qué es normal
Sin baseline, “está lento” se convierte en una comparación subjetiva. El baseline registra condiciones típicas para que una desviación sea medible.
Puede incluir:
- utilización típica de los uplinks;
- latencia interna entre segmentos;
- pérdida de paquetes en condiciones normales;
- errores de interfaz;
- disponibilidad de equipos;
- potencia PoE utilizada y disponible;
- clientes y airtime por AP;
- consumo por aplicación o sistema;
- eventos de failover;
- incidentes recurrentes.
Después de la corrección, las mismas métricas ayudan a demostrar el resultado. El baseline también permite detectar degradación gradual antes de que se convierta en indisponibilidad.
El troubleshooting por capas evita saltos de hipótesis
Un enfoque por capas no significa seguir rígidamente el modelo OSI desde la capa 1 hasta la 7 en todos los casos. Significa probar primero las hipótesis coherentes con el síntoma, manteniendo claridad sobre qué capa se está investigando.
En redes corporativas, una secuencia práctica suele separar:
- energía y medio físico;
- interfaz Ethernet y switching;
- VLANs y capa 2;
- direccionamiento y capa 3;
- servicios como DHCP, DNS y autenticación;
- seguridad y políticas;
- WAN, servidores y aplicaciones;
- Wi-Fi, cuando el acceso es inalámbrico.
Lo importante es no concluir que “el cable está mal” porque hay pérdida, ni que “el firewall bloqueó” porque un puerto no responde, sin evidencia correspondiente.
Capa física: el problema puede existir antes de IP
La capa física incluye cables, conectores, patch panels, patch cords, fibras, DIOs, interfaces, transceptores, alimentación, racks y rutas.
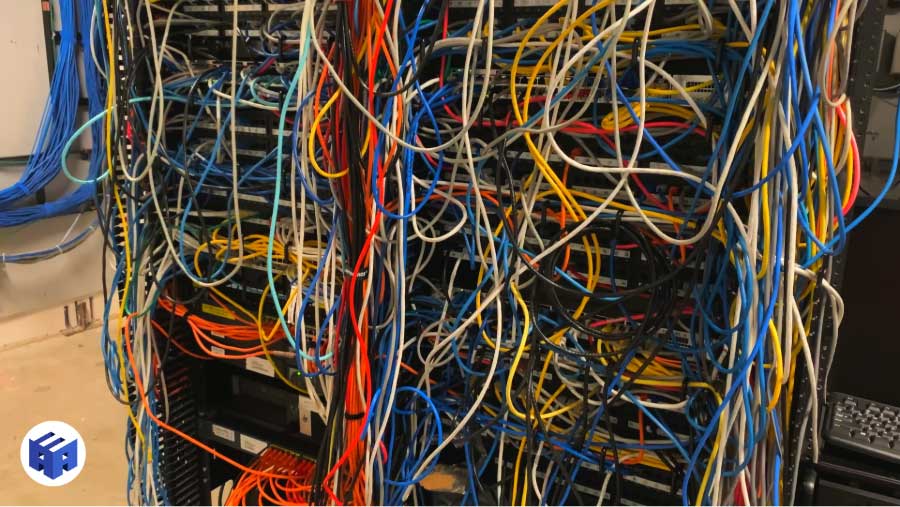
Las fallas físicas pueden producir síntomas intermitentes difíciles de reproducir. Un enlace puede establecer link y aun presentar margen insuficiente, errores, renegociación o inestabilidad bajo determinadas condiciones.
Las señales que justifican investigación física incluyen:
- velocidad negociada por debajo de lo esperado;
- link que sube y baja;
- CRC/FCS u otros errores de interfaz en aumento;
- falla concentrada en un punto o conjunto de puntos;
- comportamiento alterado después de mover patch cords;
- problemas asociados a calor, humedad, vibración o interferencia;
- PoE inestable;
- historial de terminaciones improvisadas o expansión sin control.
Continuidad no es certificación
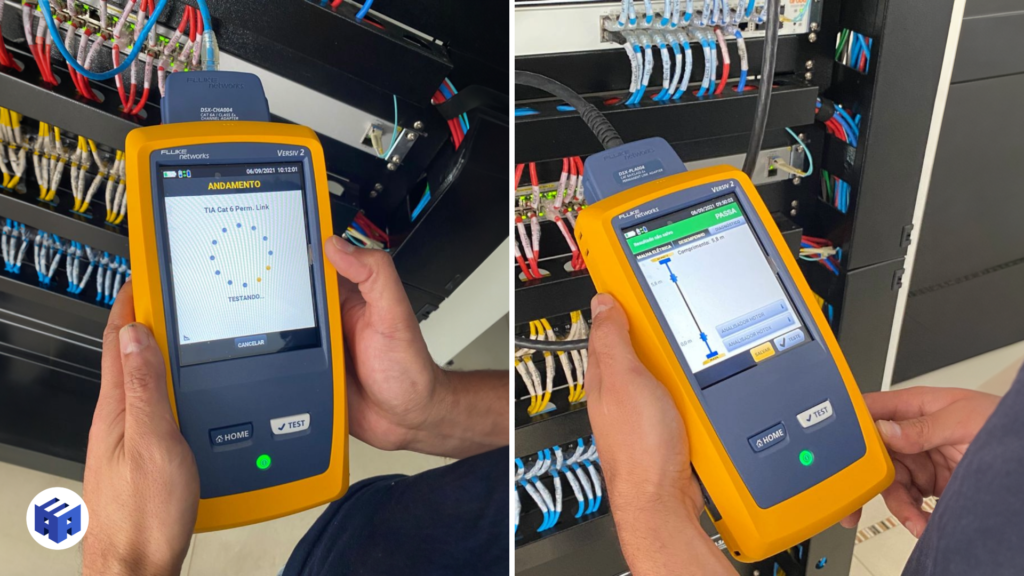
Un probador simple de continuidad verifica el mapa básico de conductores y puede localizar circuitos. Esto no demuestra que un enlace cumpla el rendimiento de una categoría/clase.
La certificación de cableado de cobre utiliza un instrumento apropiado y límites definidos para la configuración ensayada, como Permanent Link, Channel o MPTL. Entre los parámetros aplicables se encuentran pérdida de inserción, NEXT, PSNEXT, pérdida de retorno, longitud y otros previstos por el límite seleccionado.
En troubleshooting, la certificación es útil cuando existe sospecha de degradación física, instalación inadecuada, modificación de componentes o cuando la organización no posee evidencia confiable del rendimiento del enlace.
PASS/FAIL no cierra el diagnóstico
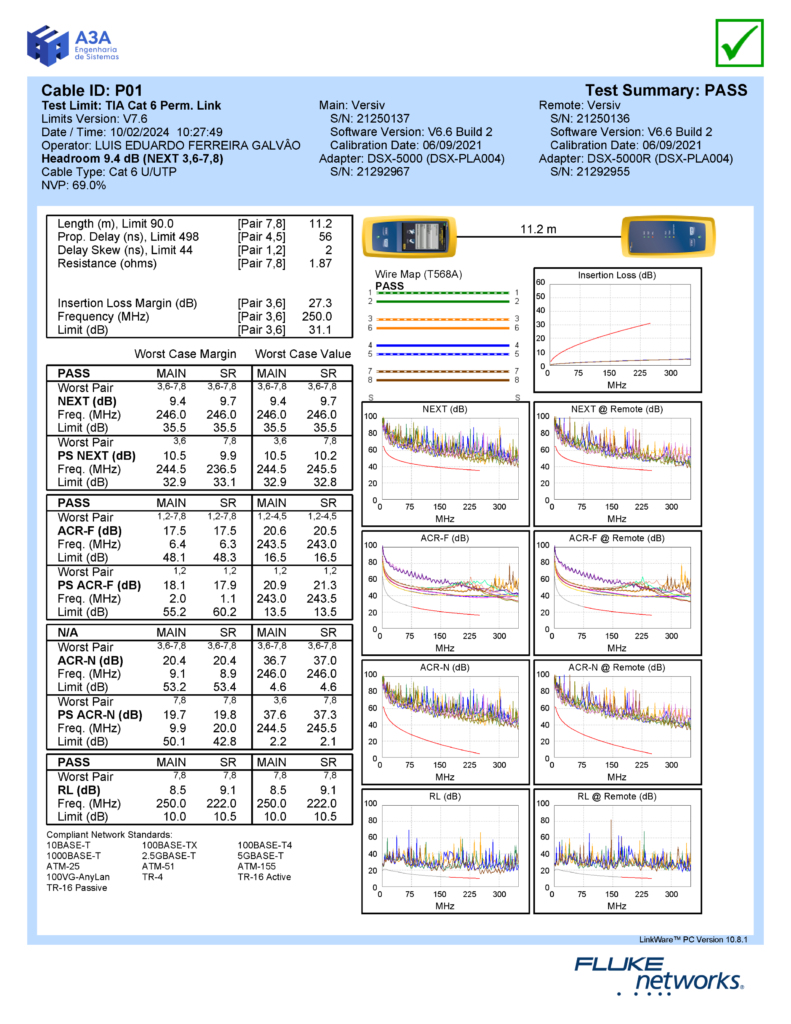
Un resultado PASS indica conformidad con el límite seleccionado en el momento de la prueba. No demuestra que toda la red lógica, el switch, el servidor o la aplicación estén correctos.
Del mismo modo, un FAIL debe interpretarse. El parámetro y la frecuencia en que ocurre la falla ayudan a orientar la investigación hacia terminación, longitud, componente, conexión o condición de instalación.
El margen también es relevante en diagnósticos comparativos: los enlaces aprobados muy próximos al límite pueden merecer atención cuando existe historial de intermitencia, aunque la decisión de intervención debe considerar el conjunto de evidencias.
Fibra óptica: la continuidad visual no basta
En un backbone óptico, el troubleshooting puede exigir inspección y limpieza de conectores, medición de potencia/pérdida y, cuando corresponda, OTDR.
OLTS/LSPM y OTDR responden preguntas diferentes. La medición de pérdida evalúa el rendimiento extremo a extremo dentro del método definido; OTDR ayuda a localizar eventos a lo largo del enlace. Uno no debe tratarse automáticamente como sustituto del otro.
Antes de concluir que un transceptor está defectuoso, verifique limpieza, conectividad, presupuesto óptico, compatibilidad, potencia recibida y condición del enlace.
PoE añade una dimensión eléctrica al troubleshooting
Cuando el dispositivo depende de Power over Ethernet, el enlace de datos y la alimentación comparten el mismo camino. Un AP o una cámara que se reinicia puede estar sufriendo un problema de potencia, no de protocolo.
La investigación debe considerar:
- estándar y clase PoE requeridos;
- potencia solicitada por el dispositivo;
- potencia disponible por puerto;
- presupuesto total del switch;
- redundancia de fuentes;
- condición del cableado y los conectores;
- longitud del canal;
- eventos de sobrecorriente o protección;
- temperatura y ventilación del rack.
Los problemas pueden aparecer solo durante picos de consumo, boot, activación de recursos o después de ampliar la cantidad de dispositivos alimentados.
Interfaz Ethernet: los contadores cuentan la historia
Un puerto aparentemente “up” todavía puede indicar un problema.
Observe, según la plataforma:
- velocidad y dúplex negociados;
- errores de recepción y transmisión;
- CRC/FCS;
- drops y discards;
- flaps de enlace;
- utilización;
- pause frames cuando estén disponibles;
- errores del módulo óptico;
- temperatura y alarmas del transceptor;
- eventos PoE.
Los contadores deben evaluarse en una ventana de tiempo. Un valor acumulado durante años es menos útil que la tasa de crecimiento durante el incidente.
Velocidad negociada por debajo de lo esperado
Una estación prevista para 1 Gb/s operando a 100 Mb/s es una pista valiosa. Puede existir un problema en pares, terminación, patch cord, configuración o capacidad del equipo.
El diagnóstico debe confirmar:
- capacidad de ambas interfaces;
- configuración de negociación;
- estado del canal físico;
- patch cords y conectores;
- errores de puerto;
- historial de flaps.
Forzar manualmente la velocidad sin comprender la causa puede ocultar el problema y crear nuevas incompatibilidades.
Switching: VLAN, STP y LACP
Después de verificar el acceso físico, la capa 2 pasa a ser candidata.
VLANs
Un puerto puede tener link y aun así no alcanzar el destino si está en la VLAN incorrecta, si la VLAN no está permitida en el trunk o si existe inconsistencia de tagging.
Compare la configuración real con la arquitectura. Los cambios de emergencia acumulados son una causa común de divergencia entre documentación y producción.
Spanning Tree
Los loops de capa 2 pueden generar tormentas, utilización elevada e inestabilidad generalizada. Los eventos de topología también pueden indicar enlaces oscilando o caminos cambiando repetidamente.
El análisis debe observar la topología esperada, root bridge, puertos bloqueados/en forwarding, cambios recientes y correlación temporal con el incidente.
LACP y agregación
Un port-channel puede permanecer activo incluso con un miembro defectuoso o una distribución inadecuada. Verifique el estado de los miembros, la consistencia de configuración, hashes, errores y capacidad efectivamente disponible.
Uplinks y oversubscription
Muchos problemas descritos como “lentitud de la red” son, en realidad, saturación en puntos de agregación.
Compare la capacidad de acceso con los uplinks y el comportamiento del tráfico. Oversubscription no es necesariamente un error; es una decisión de ingeniería que debe ser coherente con la simultaneidad y el perfil de las aplicaciones.
El diagnóstico debe observar picos, media, percentiles cuando estén disponibles, descartes en cola, utilización de interfaces y horarios de las reclamaciones.
Direccionamiento IP y gateway
Si la capa 2 funciona correctamente, verifique la configuración IP.
Preguntas básicas:
- ¿el dispositivo recibió la dirección correcta?
- ¿la máscara/prefijo es correcta?
- ¿el gateway pertenece a la red adecuada?
- ¿existe una IP duplicada?
- ¿existe una ruta hacia el destino?
- ¿el retorno sigue un camino compatible?
El ping puede demostrar alcanzabilidad, pero por sí solo no determina la calidad de la aplicación ni identifica automáticamente la causa de la pérdida.
DHCP: investigar el proceso completo
Un cliente sin dirección puede indicar indisponibilidad del servidor DHCP, relay incorrecto, VLAN equivocada, scope agotado, política de seguridad o un problema de capa 2.
El troubleshooting debe seguir la cadena desde la solicitud del cliente hasta la oferta y concesión, considerando el relay y el alcance del servicio.
Asignar una dirección estática temporal puede ayudar a aislar la hipótesis, pero no es una corrección definitiva para un problema de DHCP.
DNS: puede existir conectividad y el servicio parecer no disponible
Cuando el acceso por IP funciona y por nombre no, DNS se convierte en candidato. Verifique servidor configurado, respuesta, tiempo de resolución, registros y camino hasta el servicio.
Evite sustituir indiscriminadamente el DNS corporativo por un servidor público en producción. Los entornos internos pueden depender de zonas privadas, autenticación y políticas que no existen fuera de la organización.
Enrutamiento: ida y vuelta importan
La existencia de una ruta de ida no garantiza una comunicación funcional. Caminos asimétricos, políticas, VRFs y rutas específicas pueden afectar el retorno y la inspección del firewall.
Analice la tabla de rutas, próximo salto, prefijos, métricas y cambios recientes. Traceroute puede ayudar a visualizar parte del camino, pero las respuestas ICMP pueden filtrarse o priorizarse de forma diferente al tráfico de la aplicación.
Firewall: probar la política sin desmontar la seguridad
El antiguo procedimiento de “deshabilitar temporalmente el firewall para probar” es inadecuado en entornos productivos. El diagnóstico debe utilizar logs, sesiones, counters, políticas y captura controlada.
Verifique:
- origen y destino;
- puerto/protocolo;
- zona o interfaz;
- política coincidente;
- NAT cuando corresponda;
- estado de sesión;
- inspección de aplicación;
- autenticación;
- logs de deny/allow;
- retorno del tráfico.
Los cambios de prueba deben ser planificados, restringidos y reversibles.
Wi-Fi exige diagnóstico de RF y de la red cableada
Un problema wireless puede estar en el radio, en el cliente o en el uplink del AP.
El diagnóstico debe separar:
- cobertura;
- SNR;
- interferencia;
- utilización de canal;
- airtime;
- tasa de los clientes;
- retransmisiones;
- roaming;
- autenticación;
- DHCP;
- PoE del AP;
- velocidad del puerto;
- uplink del switch.
Una señal fuerte no significa capacidad. Un AP puede presentar RSSI adecuado y aun sufrir contención, interferencia o un cuello de botella en el camino cableado.
El servidor o la aplicación también pueden ser el cuello de botella
Si la red física, interfaces, switches, rutas y servicios están estables, la aplicación debe entrar en el análisis.
Storage, CPU, bases de datos, colas, límites de sesión, dependencias externas y arquitectura de la aplicación pueden generar lentitud percibida como “problema de red”.
Un buen troubleshooting termina cuando la evidencia localiza la causa, incluso si está fuera de la red.
WAN y proveedores externos
Internet y los circuitos entre sitios deben analizarse por separado de la LAN.
Compare latencia y pérdida en diferentes puntos del camino. Verifique interfaz local, CPE, circuito, enrutamiento y rendimiento del proveedor. En enlaces redundantes, confirme si el failover ocurrió como se esperaba y si el camino secundario posee capacidad suficiente.
Abrir un ticket con el proveedor incluyendo horario, origen, destino, mediciones y evidencias mejora la calidad de la investigación frente a la descripción genérica “Internet lenta”.
Los cambios recientes son una fuente valiosa de hipótesis
Los incidentes que aparecen poco después de cambios en switch, firmware, VLAN, patching, política de firewall, expansión de AP o migración de servidores deben correlacionarse con el cambio.
Esto no significa asumir automáticamente que el cambio es culpable, pero se convierte en una hipótesis prioritaria. La gestión de cambios y el registro de configuración reducen el tiempo de investigación porque permiten comparar el estado anterior y el actual.
Qué puede hacer de forma segura el equipo interno
Un equipo de TI puede realizar verificaciones iniciales sin convertir el troubleshooting en una intervención descontrolada:
- confirmar el alcance del impacto;
- registrar horario y síntomas;
- probar otro punto conocido como bueno;
- verificar el estado del puerto;
- consultar logs y monitoreo;
- validar IP, gateway y DNS;
- confirmar asociación y parámetros Wi-Fi;
- correlacionar con cambios;
- registrar evidencias antes de modificar.
Las acciones que afectan a múltiples usuarios — reboot del core, cambios de enrutamiento, cambios de firewall, desactivación de redundancia — requieren evaluación de impacto, ventana de mantenimiento y rollback.
¿Cuándo es necesario un diagnóstico especializado?
Cuando el incidente atraviesa varias capas, reaparece después de correcciones locales o la infraestructura no dispone de documentación confiable, el siguiente paso no debe ser sustituir equipos: debe ser construir evidencia y priorizar riesgos.
Escale cuando el incidente es recurrente, afecta sistemas críticos, cruza varias disciplinas o no puede aislarse con herramientas operativas.
Las señales claras incluyen:
- fallas físicas intermitentes;
- sospecha de cableado sin certificación;
- backbone óptico con pérdida o eventos desconocidos;
- PoE inestable;
- ausencia de documentación;
- arquitectura con múltiples puntos únicos de falla;
- problemas que reaparecen después de correcciones paliativas;
- necesidad de medir y demostrar la causa antes de invertir.
En estos casos, el diagnóstico puede incluir levantamiento, Due Diligence, certificación, mediciones, análisis de logs, revisión de arquitectura y plan de adecuación.
Certificación como herramienta de diagnóstico
La sospecha de una falla física debe medirse. Los ensayos y pruebas técnicas permiten verificar enlaces, fibras y condiciones de rendimiento con criterios documentados, transformando la percepción de inestabilidad en evidencia de ingeniería.
Cuando el problema está asociado al medio físico, certificar enlaces seleccionados o todo el sistema puede transformar una hipótesis en evidencia.
El plan debe definir límite, configuración de prueba, identificación, instrumento, calibración, tratamiento de FAIL y formato de archivos. Mezclar Permanent Link y Channel sin registrar qué se ensayó perjudica la interpretación.
Matriz de síntomas y pruebas prioritarias
| Síntoma | Primeras evidencias | Siguiente acción si persiste |
| una estación se desconecta | link, puerto, patch cord, IP | certificación del enlace / análisis de configuración |
| varias estaciones del mismo switch | uplink, CPU, energía, STP | analizar switch y dependencias |
| AP se reinicia | PoE, logs, puerto, potencia | probar canal, budget y switch |
| voz con cortes | pérdida, jitter, colas, Wi-Fi/WAN | localizar el segmento con degradación |
| solo fallan los nombres | DNS y alcance del servidor | analizar consultas y registros |
| solo falla Internet | gateway, firewall, WAN | comparar LAN vs. circuito externo |
| falla toda una VLAN | trunk, SVI/gateway, política | revisar capa 2/3 y cambios |
| el rendimiento empeora en horario pico | utilización y drops | capacidad, QoS y arquitectura |
Esta matriz no sustituye la ingeniería; organiza la secuencia de hipótesis.
Troubleshooting y MTTR
El MTTR está influido no solo por la capacidad técnica del equipo, sino también por la observabilidad y la documentación.
Si nadie sabe qué toma corresponde a qué puerto, qué uplink atiende determinado rack o qué VLAN pertenece a un sistema, cada incidente comienza reconstruyendo la red. Esto aumenta la indisponibilidad.
Identificación, topología, mapa de puertos, inventario, monitoreo y baseline reducen el tiempo necesario para localizar la falla y permiten que los especialistas avancen directamente hacia hipótesis relevantes.
Causa raíz vs. corrección paliativa
Un puerto reiniciado y un servicio restablecido no demuestran una corrección definitiva.
Después de recuperar la operación, pregunte:
- ¿qué evidencia explica la falla?
- ¿por qué ocurrió ahora?
- ¿existe otro punto sujeto al mismo mecanismo?
- ¿la corrección elimina la causa o solo el síntoma?
- ¿es necesario un proyecto de adecuación?
- ¿la documentación necesita actualizarse?
- ¿alguna métrica debe monitorearse a partir de ahora?
Este proceso transforma incidentes en mejora de ingeniería.
Los problemas recurrentes indican necesidad de adecuación
Cuando la causa raíz está en la topología, capacidad, segmentación, redundancia o diseño de switching, repetir troubleshooting no resuelve el mecanismo de la falla. La corrección definitiva pasa a ser un proyecto de red.
Si los mismos síntomas regresan, puede existir una limitación estructural: cableado degradado, uplink subdimensionado, topología inadecuada, PoE insuficiente, ausencia de redundancia, VLAN acumuladas sin gobernanza o activos sin capacidad.
En este escenario, el troubleshooting debe generar un plan de acción y, cuando sea necesario, un proyecto de adecuación. Continuar realizando correcciones locales aumenta el costo operativo y mantiene el riesgo.
Posincidente: registrar lo aprendido
Un registro de causa raíz puede contener:
- incidente e impacto;
- inicio, detección y recuperación;
- evidencias recopiladas;
- causa inmediata;
- causa raíz;
- factores contribuyentes;
- corrección aplicada;
- acciones preventivas;
- responsables y plazos;
- actualización de documentación;
- indicadores que pasarán a monitorearse.
Este historial evita repetir investigaciones y permite identificar patrones.
Consideraciones finales
El troubleshooting de redes es un proceso de ingeniería de diagnóstico. Cuanto mayor es la criticidad, menos espacio existe para ensayo y error. El enfoque correcto delimita el dominio de falla, preserva evidencias, prueba hipótesis, mide la red por capas y solo entonces aplica la corrección.
La red más fácil de diagnosticar es aquella que ya posee identificación, documentación, baseline y monitoreo. Cuando los problemas recurrentes pasan a generar evidencia, causa raíz y un plan de adecuación, la organización deja de limitarse a reaccionar ante incidentes y comienza a aumentar la confiabilidad de forma estructurada.
Referencias técnicas
[1] IEEE. IEEE 802.3 — Ethernet. Disponible en: https://standards.ieee.org/ieee/802.3/7071/
[2] ISO/IEC. ISO/IEC 11801-1:2017 — Information technology — Generic cabling for customer premises — Part 1: General requirements. Disponible en: https://www.iso.org/standard/66182.html
[3] IEC. IEC 61935-1:2019 — Specification for the testing of balanced and coaxial information technology cabling. Disponible en: https://webstore.iec.ch/en/publication/31201
[4] IETF. RFC 2131 — Dynamic Host Configuration Protocol. Disponible en: https://datatracker.ietf.org/doc/html/rfc2131
[5] IETF. RFC 1034 — Domain Names — Concepts and Facilities. Disponible en: https://datatracker.ietf.org/doc/html/rfc1034
[6] ABNT. ABNT NBR 14565 — Cableado estructurado para edificios comerciales y data centers. Catálogo ABNT. Disponible en: https://www.abntcatalogo.com.br/
Preguntas frecuentes
Definir el síntoma y delimitar el dominio de falla: quién está afectado, qué sistemas comparten el problema, cuándo comenzó y qué elementos son comunes a los dispositivos impactados.
No. El ping ayuda a probar alcanzabilidad y latencia ICMP, pero por sí solo no demuestra el rendimiento de la aplicación, calidad del cableado, DNS, políticas de firewall o capacidad de los uplinks.
No. La continuidad verifica principalmente el mapa de conductores. La certificación mide parámetros del enlace frente a límites técnicos de la categoría/clase y de la configuración de prueba aplicable.
Cuando hay renegociación de velocidad, flaps, errores de interfaz, intermitencia localizada, PoE inestable, historial de terminaciones problemáticas o ausencia de evidencia de certificación.
En producción, esta no debe ser la estrategia estándar. Prefiera logs, sesiones, counters, captura y reglas de prueba controladas, con evaluación de impacto y rollback.
Cuando los incidentes son recurrentes, la causa está en limitaciones estructurales de capacidad, arquitectura, PoE, cableado, redundancia o documentación y las correcciones puntuales no eliminan el mecanismo de la falla.
Materiales técnicos complementarios
Soluciones relacionadas
Servicios relacionados
- Due Diligence Técnica de Ingeniería
- Ensayos y Pruebas Técnicas
- Diseño de Red Lógica y Redes Corporativas
- Consultoría Cisco para diagnóstico, diseño y modernización de redes
