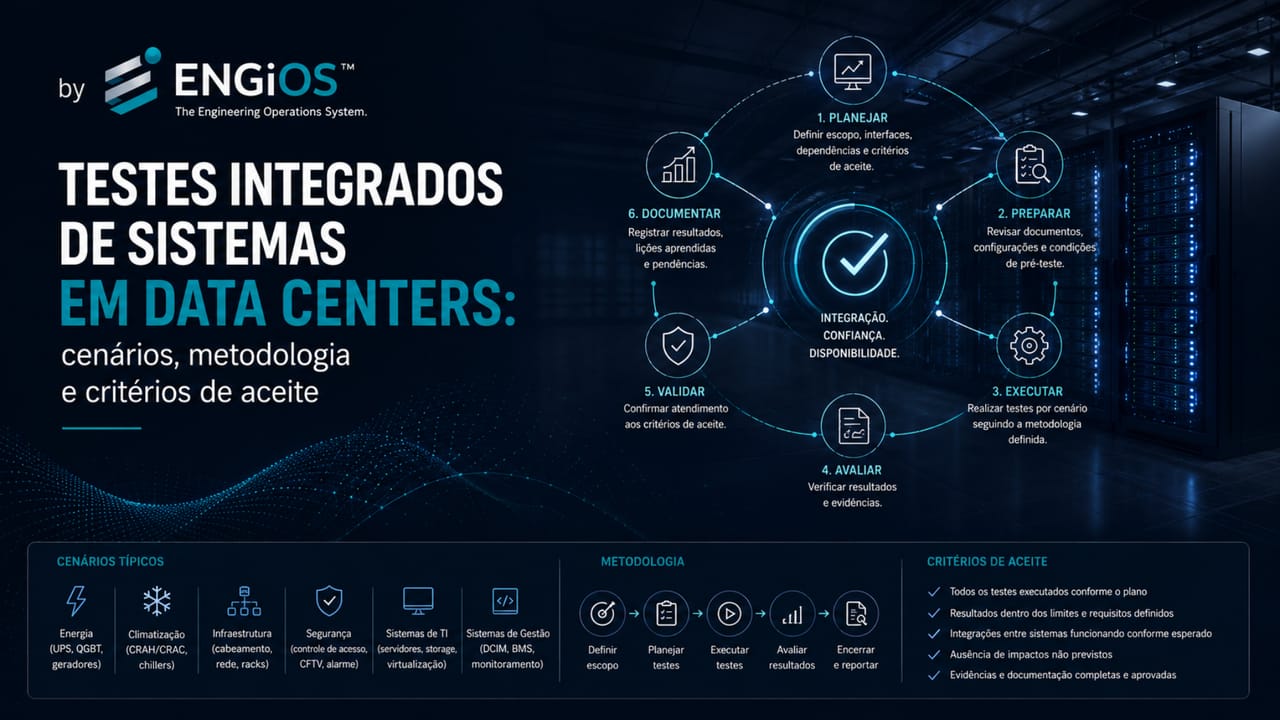
Comprenda IST en Data Centers: escenarios, fallas, transiciones, readiness, seguridad, evidencias, criterios de aceptación, retests y gobernanza de commissioning.
¡Descúbrelo!
Las Pruebas Integradas de Sistemas en Data Centers verifican si la infraestructura crítica responde de forma coordinada cuando ocurre un cambio de estado, un mantenimiento planificado, una falla, una condición degradada o una emergencia. El objetivo no es solamente confirmar que cada equipo funciona aisladamente, sino demostrar que energía, climatización, automatización, telecomunicaciones, seguridad, incendios, controles y operación preservan conjuntamente la función crítica dentro de los límites definidos.
Esta distinción es esencial. Un UPS puede haber sido aprobado en la prueba funcional; un grupo electrógeno puede haber completado su arranque; un chiller puede haber alcanzado la capacidad nominal; el BMS puede haber recibido los puntos previstos. Aun así, la infraestructura puede fallar cuando estos sistemas deben actuar en secuencia. Es precisamente en esta frontera entre sistemas donde surgen retrasos de comando, interbloqueos inconsistentes, alarmas ambiguas, dependencias ocultas, fallas de comunicación, prioridades incorrectas y dificultades para retornar al estado normal.
En este contexto, IST significa Integrated Systems Testing o Integrated Systems Test: la verificación integrada orientada a escenarios que evalúa interfaces, estados degradados, fallas, recuperación y respuesta operacional. Este artículo profundiza en cómo estructurar, ejecutar, registrar y aceptar este tipo de prueba en Data Centers, distinguiéndolo de los niveles anteriores del proceso de commissioning.
¿Qué son las Pruebas Integradas de Sistemas en Data Centers?
La prueba integrada de sistemas es una verificación orientada a escenarios. Provoca o simula eventos previamente definidos y observa si los sistemas involucrados responden de acuerdo con los requisitos del propietario, la base de diseño, las secuencias de operación, las lógicas de control, los procedimientos aprobados y los criterios de desempeño. En el ciclo completo, esta etapa sucede a verificaciones anteriores como FAT, SAT, pre-commissioning y pruebas funcionales; la visión de los niveles y gates está en el artículo sobre Commissioning de Data Center, mientras que la distinción entre FAT, SAT y pruebas integradas se profundiza por separado.
En lugar de preguntar solamente “¿el equipo funcionó?”, el IST busca responder:
- ¿el evento fue detectado correctamente?
- ¿las protecciones actuaron en el orden esperado?
- ¿la carga crítica permaneció atendida?
- ¿el sistema alternativo entró en operación dentro del tiempo requerido?
- ¿la capacidad remanente fue suficiente?
- ¿las condiciones térmicas permanecieron dentro de los límites?
- ¿las alarmas fueron recibidas, priorizadas y comprendidas?
- ¿el equipo identificó el estado real de la instalación?
- ¿el sistema permaneció estable durante el período definido?
- ¿el retorno al estado normal ocurrió de forma segura?
- ¿la redundancia fue recompuesta y confirmada?
- ¿las evidencias permiten demostrar el resultado?
Un escenario de pérdida de alimentación de la compañía eléctrica, por ejemplo, puede involucrar detección de la condición, actuación de protecciones, sostenimiento mediante UPS y baterías, arranque de grupos electrógenos, transferencia de cargas, priorización de sistemas auxiliares, continuidad de la climatización, actualización de supervisores, generación de alarmas, actuación del equipo y posterior retorno a la condición normal.
El resultado no puede reducirse a “no hubo desconexión”. La prueba debe demostrar que la respuesta completa fue coherente con los requisitos y que no surgieron condiciones ocultas capaces de comprometer la operación futura.
IST, SAT, prueba funcional y prueba de desempeño
La terminología debe definirse en el plan de commissioning y en el contrato, porque diferentes organizaciones utilizan nomenclaturas propias. La diferencia práctica está en el objeto de la verificación: el SAT observa la aceptación en campo de un equipo o sistema; la prueba funcional demuestra funciones dentro de una disciplina; el IST verifica interfaces y respuesta conjunta; y la prueba de desempeño comprueba parámetros medibles bajo condiciones definidas.
| Modalidad | Foco principal | Ejemplo en Data Center |
|---|---|---|
| SAT — Site Acceptance Test | Aceptación en campo después de la instalación | Configuración, energización, comunicación y desempeño específico de un UPS o tablero |
| Prueba funcional | Funciones, secuencias e interbloqueos de un sistema | Transferencia a baterías, bypass, alarmas y reparto de carga del sistema UPS |
| IST — Integrated Systems Testing | Interacción entre sistemas en un escenario común | Pérdida de fuente con actuación coordinada de UPS, generadores, distribución, climatización, BMS, EPMS y operación |
| Prueba de desempeño | Parámetros garantizados en condición definida | Capacidad, autonomía, tiempos, condiciones ambientales o desempeño bajo carga |
El IST puede incorporar mediciones de desempeño, pero su característica distintiva es verificar la cadena de interfaces. ABNT NBR IEC 62337 refuerza que las condiciones de partida, instrumentación, métodos de medición, tolerancias, duración, evaluación e informes deben definirse previamente cuando haya demostración de desempeño.
Fundamentación técnica y normativa
ABNT NBR ISO/IEC 22237-1 establece que la operación, la gestión, los procesos y los indicadores deben considerarse desde el diseño. La norma también orienta que procesos, roles y responsabilidades se definan antes del inicio de la operación y que el equipo operacional sea instruido sobre la infraestructura y entrenado durante las pruebas de aceptación.
La misma norma determina que la verificación de aceptación y el commissioning se realicen antes de la entrega del Data Center a operación. Sus conceptos de disponibilidad, confiabilidad y resiliencia refuerzan que una instalación no debe evaluarse solamente por la existencia de componentes redundantes, sino por su capacidad de desempeñar la función prevista y resistir fallas.
ABNT NBR IEC 62337, aunque tiene origen en sistemas eléctricos, instrumentación y control de procesos industriales, proporciona principios directamente aplicables a la gobernanza del commissioning: fases e hitos definidos, planificación de pruebas, documentación, responsabilidades, listas de pendientes, procedimientos detallados, registros operacionales, condiciones de readiness, evaluación formal y aceptación por el propietario.
El Tier Standard: Operational Sustainability de Uptime Institute incluye la prueba operacional de sistemas integrados como comportamiento preoperacional relevante para instalaciones de mayor criticidad. El mismo estándar destaca que commissioning, capacitación, procedimientos, mantenimiento y gestión son necesarios para que la infraestructura alcance el potencial de desempeño de su topología.
Las normas específicas continúan siendo aplicables a las disciplinas. ABNT NBR 17207 establece criterios ambientales para entornos de TIC y Data Centers; ABNT ISO/IEC TS 22237-5 trata la disponibilidad y los múltiples caminos de la infraestructura de telecomunicaciones; y ABNT NBR 17240 establece requisitos propios para sistemas de detección y alarma de incendios. El IST debe integrar interfaces sin sustituir ensayos legales, aceptaciones regulatorias o responsabilidades técnicas específicas.
¿Cuál es el objetivo del IST?
El objetivo del IST debe definirse a partir de los requisitos del emprendimiento. La primera dimensión es funcional: demostrar que la carga crítica permanece atendida, que protecciones e interbloqueos actúan correctamente y que los sistemas coordinan sus respuestas sin crear estados conflictivos.
La segunda dimensión es de resiliencia y operación. La prueba debe mostrar la capacidad remanente en estados degradados, el mantenimiento de las condiciones ambientales, la estabilidad durante el período de observación y la posibilidad de recuperar la instalación y recomponer la redundancia. BMS, EPMS, DCIM y demás plataformas deben registrar los eventos de forma coherente para que el equipo comprenda el estado real del Data Center.
Finalmente, el resultado debe ser trazable: datos, tiempos, tendencias, alarmas, intervenciones y decisiones deben permitir reconstruir el escenario y sustentar la aceptación. El objetivo no es probar que “todo funciona al mismo tiempo”, sino confirmar escenarios seleccionados con base en riesgos, requisitos, arquitectura y modos de falla relevantes.
IST no es una demostración ensayada
La prueba debe producir evidencias sobre la respuesta coordinada de los sistemas, incluidos estados intermedios, limitaciones y condiciones degradadas.
El IST debe estar orientado por requisitos y riesgos
Los scripts genéricos producen pruebas genéricas. La matriz de escenarios debe derivar de los documentos que definen el emprendimiento, incluyendo:
- OPR, URS o requisitos del propietario;
- Basis of Design;
- diagramas unifilares y funcionales;
- secuencias de operación;
- matrices de causa y efecto;
- estudios de selectividad, cortocircuito y coordinación;
- listas de cargas y prioridades;
- memorias de cálculo;
- análisis de modos de falla;
- análisis de riesgo del negocio;
- requisitos de disponibilidad;
- contratos y garantías de desempeño;
- manuales de fabricantes;
- MOPs, SOPs y EOPs;
- requisitos legales y de las autoridades competentes.
El análisis debe identificar qué eventos pueden comprometer la función crítica, qué interfaces participan en la respuesta y qué evidencias demuestran el resultado.
Una matriz de trazabilidad permite relacionar:
requisito → riesgo → escenario → estímulo → respuesta esperada → variable medida → criterio de aceptación → evidencia → responsable de aprobación.
Esta estructura reduce brechas y evita que la prueba sea definida solamente con base en la experiencia informal de los participantes.
Readiness es un gate, no una percepción
El IST solo debe comenzar cuando requisitos, configuración, sistemas individuales, instrumentos, equipo y criterios de restauración hayan sido formalmente verificados.
Estructure la gobernanza técnica con Owner’s Engineering para Data Centers
Prerrequisitos para iniciar las pruebas integradas
El IST no debe utilizarse para descubrir pendientes básicos de instalación. Antes de autorizar los escenarios, conviene realizar una revisión formal de readiness.
Requisitos y documentación actualizados
Los documentos deben representar la instalación real. Diagramas desactualizados, lógicas modificadas en campo, etiquetas divergentes y secuencias no revisadas comprometen la seguridad y la validez de la prueba.
La base mínima incluye:
- OPR, URS y Basis of Design aprobados;
- diagramas as-built disponibles;
- secuencias de operación actualizadas;
- lista de puntos de automatización;
- matrices de interbloqueo y causa-efecto;
- configuraciones de sistemas registradas;
- manuales y documentación de proveedores;
- procedimientos de operación y emergencia;
- matriz de escenarios y criterios de aceptación.
Sistemas individuales concluidos
Los componentes y sistemas involucrados deben haber concluido las pruebas anteriores previstas en el plan. Según la metodología, esto incluye FAT, recepción, inspección, prefuncionamiento, arranque, SAT y pruebas funcionales.
Iniciar el IST con sistemas básicos todavía inestables genera resultados inconclusos y aumenta el riesgo de daño.
Pendientes clasificados
La punch list debe revisarse por criticidad. Los pendientes que puedan alterar la respuesta del escenario, impedir observabilidad, comprometer seguridad o exigir intervención improvisada deben cerrarse antes de la prueba.
Los pendientes aceptados temporalmente deben estar documentados, acompañados de análisis de impacto y aprobación de la autoridad designada.
Configuración controlada
El estado inicial de los sistemas debe ser conocido y registrado. Esto incluye:
- equipos en servicio y reserva;
- alineación de válvulas;
- posición de interruptores y seccionadores;
- modos automático, manual o mantenimiento;
- setpoints;
- alarmas inhibidas;
- bypasses activos;
- lógicas temporales;
- versiones de software y firmware;
- indisponibilidades existentes.
Sin control de configuración, el resultado no puede reproducirse ni compararse.
Instrumentación y observabilidad disponibles
Los sistemas deben registrar lo ocurrido. BMS, EPMS, DCIM y plataformas específicas deben estar operativos, con tendencias configuradas, historiales disponibles y relojes sincronizados.
Cuando los instrumentos permanentes no sean suficientes, deben utilizarse instrumentos temporales adecuados y calibrados.
Equipo y responsabilidades definidos
La prueba debe poseer una estructura de mando clara. Todos los participantes deben saber quién:
- autoriza el inicio;
- conduce el script;
- ejecuta las maniobras;
- monitorea cada sistema;
- registra los datos;
- puede interrumpir la prueba;
- aprueba el retorno al estado normal;
- clasifica las incidencias;
- acepta el resultado.
Gobernanza y autoridad durante el IST
Las pruebas integradas involucran múltiples organizaciones: propietario, operación, agente de commissioning, diseñadores, constructores, integradores, proveedores, equipo de TI, seguridad, incendios y especialistas de sistemas.
Una matriz RACI debe definir responsabilidades por actividad y escenario. En términos generales:
- el propietario define requisitos y acepta el resultado;
- el agente de commissioning coordina independencia, trazabilidad y proceso de verificación;
- la operación valida condiciones, ejecuta o acompaña maniobras y confirma la posibilidad de sostener el activo;
- los proveedores apoyan pruebas de sus equipos y límites de garantía;
- los diseñadores aclaran intenciones, secuencias y criterios;
- los integradores apoyan lógicas, comunicación y supervisión;
- la seguridad laboral controla riesgos y permisos;
- la TI confirma impacto y continuidad de la carga tecnológica.
La autoridad para abortar debe ser explícita. Cualquier participante designado debe poder interrumpir la prueba cuando exista riesgo para personas, equipos, carga crítica o integridad de la instalación.
Cómo estructurar una matriz de escenarios
La matriz de IST debe organizar los eventos de forma comprensible y trazable. Cada fila puede contener:
- código del escenario;
- requisito relacionado;
- sistema iniciador;
- evento o condición simulada;
- sistemas participantes;
- configuración inicial;
- precondiciones;
- estímulo aplicado;
- respuesta esperada;
- tiempos máximos o rangos aceptables;
- variables monitoreadas;
- criterios de aborto;
- procedimiento de restauración;
- evidencias requeridas;
- responsables;
- resultado y número de issue, cuando corresponda.
La matriz debe ser revisada por las disciplinas involucradas. Un escenario aparentemente eléctrico puede exigir participación mecánica, de automatización, telecomunicaciones y operación.
Familias de escenarios para Data Centers
Operación normal
Verifica condiciones estables y transiciones previstas sin falla, como:
- alternancia programada de equipos redundantes;
- rotación de unidades líderes y de reserva;
- modulación de capacidad;
- transferencia controlada de caminos;
- cambio autorizado de setpoints;
- retorno al estado inicial;
- comportamiento de alarmas informativas.
Estos escenarios confirman si la instalación puede ejecutar las rutinas necesarias sin generar degradaciones inesperadas.
Mantenimiento planificado
Evalúa la retirada controlada de un componente o camino para mantenimiento. Debe verificar:
- capacidad remanente;
- aislamiento seguro;
- continuidad de la carga;
- estabilidad térmica;
- alarmas esperadas;
- actualización de los supervisores;
- exposición a una falla adicional;
- retorno y recomposición de la redundancia.
El artículo sobre mantenimiento concurrente en Data Centers profundiza los criterios específicos de esta condición.
Falla de fuente o componente
Puede incluir pérdida de:
- alimentación de la compañía eléctrica;
- transformador;
- tablero o barra;
- módulo de UPS;
- banco de baterías o string;
- grupo electrógeno;
- bomba;
- chiller;
- torre de refrigeración;
- CRAH o CRAC;
- controlador;
- red de comunicación;
- sensor crítico.
El escenario debe respetar las limitaciones de los fabricantes y evitar métodos destructivos no previstos. Cuando la falla real no pueda aplicarse con seguridad, puede utilizarse una simulación autorizada, siempre que se demuestre su representatividad.
Estado degradado
La prueba debe observar el comportamiento de la instalación después de la pérdida de redundancia, incluso si la carga permanece atendida.
Es necesario verificar:
- capacidad disponible;
- márgenes térmicos y eléctricos;
- alarmas y prioridades;
- restricciones operacionales;
- tiempo máximo permitido en esta condición;
- acciones requeridas del equipo;
- riesgo de falla adicional;
- criterios de escalamiento.
Fallas de comunicación y automatización
La infraestructura física puede permanecer disponible mientras la supervisión pierde visibilidad o los controladores dejan de coordinar las secuencias.
Los escenarios relevantes incluyen:
- pérdida de red del BMS;
- falla de servidor o estación de operación;
- pérdida de comunicación con PLC, UPS, generador o medidor;
- divergencia entre estado local y supervisor;
- congelamiento de valor;
- falla de sensor;
- pérdida de sincronización de tiempo;
- indisponibilidad del historial;
- actuación en modo local o degradado.
La prueba debe confirmar que la falla de monitoreo no provoca comandos indebidos y que el equipo puede identificar la condición real.
Incendios y seguridad
Las interfaces de incendio pueden involucrar detección, alarma, supresión, desconexión o mantenimiento de equipos, control de acceso, liberación de puertas, ascensores, climatización, dampers, energía y comunicación.
Cada escenario debe respetar ABNT NBR 17240, el diseño aprobado, las exigencias de las autoridades competentes y las responsabilidades de los profesionales habilitados.
El IST no sustituye el commissioning propio del sistema de incendios. Verifica las interfaces necesarias para la respuesta integrada del Data Center.
Condiciones ambientales
Pueden evaluarse pérdida de unidad de refrigeración, falla de bomba, indisponibilidad de circuito, cambio de caudal, pérdida de contención, variación de setpoint o falla de sensor.
Las mediciones deben observar, según corresponda:
- temperatura de entrada de los equipos de TIC;
- humedad y punto de rocío;
- caudal de aire o líquido;
- presión diferencial;
- temperatura del agua;
- tiempo de respuesta;
- estabilidad después del evento;
- hotspots y recirculación.
NBR 17207 establece que los parámetros ambientales deben asegurarse en las condiciones de diseño y que el análisis debe considerar carga térmica, variaciones, redundancia y confiabilidad.
Recuperación y retorno al estado normal
El escenario no termina cuando la carga permanece energizada. Es necesario probar:
- retorno de la fuente principal;
- resincronización y transferencia;
- parada y enfriamiento de generadores;
- recarga de baterías;
- retorno de equipos de reserva;
- recomposición de válvulas y caminos;
- normalización de setpoints;
- limpieza de alarmas;
- confirmación de redundancia;
- estabilidad posterior;
- actualización de los registros operacionales.
Muchas fallas aparecen durante la restauración y no durante el evento inicial.
El escenario solo termina después de recomponer la redundancia
El retorno de la fuente, la normalización de controles, la limpieza de alarmas y la confirmación de estabilidad forman parte de la prueba y de los criterios de aceptación.
Conecte los resultados del IST con los procedimientos MOP, SOP y EOP de operación →
Cómo escribir un script de prueba integrada
El script debe ser ejecutable, auditable y seguro. Debe contener al menos los elementos siguientes.
Identificación y objetivo
Indicar código, título, sistemas participantes, requisito asociado, riesgo evaluado y resultado que se pretende demostrar.
Referencias
Relacionar diagramas, secuencias, manuales, estudios, procedimientos, matriz de causa-efecto y documentos normativos utilizados.
Configuración inicial
Describir el estado necesario para iniciar el escenario, incluyendo equipos activos, reservas, posiciones, setpoints, cargas, modos de control, alarmas e indisponibilidades.
Precondiciones y gate
Definir condiciones que deben confirmarse antes del inicio:
- sistemas disponibles;
- pendientes aceptados;
- instrumentos instalados;
- comunicación probada;
- equipo presente;
- permisos válidos;
- condiciones ambientales estables;
- plan de restauración verificado.
Pasos de ejecución
Cada paso debe indicar:
- acción;
- ejecutor;
- resultado esperado;
- punto de observación;
- registro requerido;
- criterio de avance.
La redacción debe evitar comandos vagos como “simular falla”. Debe especificarse el método autorizado y el punto exacto de actuación.
Criterios de aborto
Deben definirse límites objetivos para interrumpir la prueba, como:
- pérdida no prevista de la carga crítica;
- temperatura por encima del límite establecido;
- sobrecarga de equipo o camino;
- actuación de protección no prevista;
- pérdida de comunicación indispensable para la seguridad;
- fuga, humo, ruido o vibración anormal;
- imposibilidad de ejecutar la restauración;
- condición no comprendida por el equipo.
Plan de restauración
El script debe establecer cómo retornar a una condición segura, incluso en caso de falla de la propia prueba. El plan debe considerar acciones manuales, responsables, comunicación, equipos de apoyo y condiciones para reinicio.
Criterios de aceptación
Cada respuesta esperada debe poseer una condición medible o verificable. “Funcionamiento normal” no es un criterio suficiente.
Seguridad durante la ejecución
El IST puede involucrar energía eléctrica, combustibles, baterías, sistemas presurizados, equipos rotativos, altas temperaturas, agua, agentes de supresión, alarmas y cambios temporales de redundancia.
La planificación debe integrar:
- análisis de riesgo de la tarea;
- permisos de trabajo;
- bloqueo y etiquetado, cuando corresponda;
- recomendaciones de fabricantes;
- límites de responsabilidad;
- protección individual y colectiva;
- comunicación de emergencia;
- presencia de especialistas;
- control de accesos;
- gestión de cambios temporales;
- plan de contingencia;
- autoridad de aborto.
Ningún objetivo de commissioning justifica una intervención insegura. Cuando la falla real no pueda provocarse de forma controlada, debe utilizarse un método alternativo técnicamente fundamentado.
Instrumentación, sincronización y evidencias
La calidad del resultado depende de la calidad de la medición. El IST debe capturar no solamente el estado final, sino la secuencia temporal del evento.
Instrumentos posibles
- analizadores de calidad de energía;
- registradores eléctricos;
- oscilografía y registros de protección;
- termografía;
- sensores temporales de temperatura y humedad;
- medidores de caudal y presión;
- bancos de carga resistivos o reactivos;
- registradores de rotación y vibración;
- logs de PLC y controladores;
- tendencias de BMS y EPMS;
- eventos de DCIM;
- registros de sistemas de incendios y seguridad;
- captura de red;
- video sincronizado de las operaciones.
Sincronización de tiempo
Los relojes divergentes impiden reconstruir el evento. Antes de las pruebas, debe verificarse la sincronización entre instrumentos, BMS, EPMS, DCIM, PLCs, sistemas de seguridad, cámaras y registros manuales.
Cuando no exista sincronización automática, debe establecerse un método de correlación.
Tasa de muestreo
La frecuencia de registro debe ser compatible con la velocidad del fenómeno. Un intervalo adecuado para tendencias térmicas puede ser insuficiente para capturar transferencias eléctricas, actuación de protecciones o transitorios.
Evidencia mínima
Para cada escenario, conviene reunir:
- script aprobado;
- lista de participantes;
- configuración inicial;
- registros de briefing;
- datos brutos;
- tendencias y eventos;
- fotografías o videos relevantes;
- anotaciones cronológicas;
- desvíos observados;
- issues abiertas;
- resultado del retest;
- aprobación final.
Ejecución paso a paso
1. Reunión de readiness
El equipo revisa objetivo, riesgos, configuración, responsabilidades, criterios de aborto y restauración. Cualquier duda crítica impide el inicio.
2. Registro del baseline
Antes del estímulo, se registran estados, cargas, temperaturas, presiones, alarmas y equipos en servicio. Este baseline permite comparar el comportamiento posterior.
3. Aplicación del estímulo
El evento se provoca o simula conforme al método aprobado. La ejecución debe seguir estrictamente el script.
4. Observación de la respuesta
Cada disciplina acompaña sus variables y confirma eventos esperados. Las intervenciones no previstas deben registrarse.
5. Permanencia en condición representativa
Cuando corresponda, el estado degradado debe mantenerse durante tiempo suficiente para demostrar estabilidad, capacidad y condiciones ambientales.
6. Restauración
El equipo ejecuta la secuencia de retorno y confirma la recomposición de sistemas, alarmas y redundancias.
7. Verificación posterior a la prueba
Se revisan estados finales, condiciones anormales, alarmas latentes, cambios temporales, herramientas y bloqueos.
8. Debriefing inmediato
Los participantes registran observaciones mientras el evento todavía está reciente. Se consolidan resultados preliminares, desvíos y acciones.
Criterios de aceptación del IST
Los criterios deben establecerse antes de la ejecución y vincularse con los requisitos del emprendimiento. La aceptación no debe depender solamente de la continuidad de la carga: es necesario demostrar función, tiempos, capacidad, condiciones ambientales, observabilidad, respuesta operacional y restauración completa.
| Dimensión | Qué debe demostrarse |
|---|---|
| Funcional | Secuencias, protecciones e interbloqueos correctos; cargas críticas preservadas; sistemas alternativos disponibles; automatización coherente y ausencia de comandos conflictivos. |
| Temporal | Tiempos de detección, transferencia, arranque, estabilización, autonomía, respuesta térmica, recuperación y generación de alarmas dentro de los límites definidos. |
| Capacidad y ambiente | Cargas dentro de los límites de los equipos, margen remanente adecuado, capacidad térmica suficiente y condiciones ambientales compatibles con los requisitos. |
| Observabilidad | Eventos registrados, alarmas correctas y priorizadas, estados locales y remotos coherentes, datos suficientes para reconstrucción y sincronización temporal adecuada. |
| Operacional | Equipo capaz de reconocer la condición, aplicar procedimientos, escalar incidencias y ejecutar acciones sin improvisación. |
| Restauración | Estado normal recompuesto, redundancia confirmada, alarmas tratadas, setpoints restaurados, cambios temporales eliminados y estabilidad verificada después del retorno. |
Un escenario puede mantener la carga energizada y aun ser rechazado si presenta sobrecarga, pérdida de monitoreo, respuesta térmica inadecuada, alarmas incorrectas, actuación manual no prevista o imposibilidad de restauración segura.
La continuidad de la carga no es el único criterio de aprobación
La aceptación debe considerar función, tiempos, capacidad, ambiente, observabilidad, respuesta operacional y restauración completa.
Integre requisitos, pruebas, evidencias y aceptación en una única gobernanza de ingeniería →
Gestión de issues, fallas y retests
Toda divergencia entre el resultado esperado y el observado debe generar un registro. La issue debe contener:
- identificación del escenario y paso;
- descripción objetiva;
- hora y condición observada;
- impacto;
- evidencias;
- responsable del análisis;
- causa probable;
- acción correctiva;
- necesidad de modificación documental;
- criterio de cierre;
- retest requerido.
No se debe borrar el historial de fallas después de la corrección. La trazabilidad demuestra cómo evolucionó la instalación y evita que problemas semejantes reaparezcan.
Clasificación por criticidad
Una clasificación práctica puede considerar:
- crítica: compromete seguridad, carga crítica o validez del escenario;
- alta: impide un requisito de disponibilidad o restauración;
- media: reduce desempeño, observabilidad o capacidad operacional;
- baja: desvío documental o de acabado sin impacto inmediato en la función.
La clasificación debe ser definida por el emprendimiento.
Retest
El retest debe verificar la corrección sin perder la visión sistémica. En algunos casos, repetir solamente el paso afectado es suficiente. En otros, la modificación puede impactar interfaces y exigir la repetición del escenario completo o de una familia de escenarios.
Verificación por disciplina
Sistema eléctrico
Los escenarios pueden involucrar fuentes, transformadores, tableros, UPS, baterías, generadores, ATS, STS, PDU, distribución A/B, protecciones y EPMS.
Deben observarse:
- continuidad de la carga;
- selectividad y actuación de protección;
- tiempos de transferencia;
- estabilidad de tensión y frecuencia;
- reparto de carga;
- autonomía;
- arranque y paralelismo;
- prioridad de cargas;
- comportamiento de bypass;
- recomposición después del retorno.
Climatización
La prueba debe considerar la respuesta coordinada de chillers, bombas, torres, CRAH, CRAC, CDU, válvulas, controles, contención y sensores.
Deben verificarse:
- capacidad remanente;
- secuencia de arranque y parada;
- estabilidad de presión y caudal;
- mantenimiento de temperatura y humedad;
- respuesta a pérdida de unidad o circuito;
- comportamiento de la automatización;
- tiempo de recuperación;
- condiciones durante energía de emergencia.
Automatización y supervisión
BMS, EPMS, PLC y DCIM deben registrar y presentar la condición correcta. La prueba debe verificar alarmas, prioridades, timestamps, estados, comandos, permisivos, tendencias y fallas de comunicación.
Telecomunicaciones y red
ABNT ISO/IEC TS 22237-5 establece múltiples caminos físicos para clases superiores de disponibilidad y destaca la necesidad de redundancia en los equipos activos. El IST debe evaluar caminos, reconvergencia, pérdida de enlace, comunicación de control e impacto sobre sistemas supervisores.
Incendios y seguridad
Las interfaces deben verificarse según el diseño y las normas aplicables. Esto puede incluir detección, alarma, liberación de accesos, actuación de dampers, climatización, desconexiones autorizadas, supresión y comunicación.
Pruebas integradas en Data Centers existentes
En instalaciones en operación, el riesgo es mayor porque la carga real está presente. El alcance debe adaptarse con base en análisis de riesgo y criticidad.
Pueden utilizarse enfoques como:
- revisión documental y walkdown;
- simulación autorizada de señales;
- ensayos en ventanas de mantenimiento;
- uso de cargas temporales;
- pruebas por subsistema o zona;
- ejecución en entorno redundante;
- digital twin o simulación complementaria;
- verificación de escenarios seleccionados;
- recommissioning después de cambios.
El artículo sobre recommissioning después de expansión o modernización detalla la necesidad de redefinir el baseline después de modificaciones.
Ninguna limitación debe ocultarse. El informe debe indicar qué escenarios fueron probados, simulados, inferidos o no ejecutados.
Entregables de las pruebas integradas
Un programa completo puede producir:
- plan de IST;
- matriz de requisitos y escenarios;
- matriz de interfaces;
- análisis de riesgo de las pruebas;
- revisión de readiness;
- scripts aprobados;
- registros de briefing;
- datos brutos y tendencias;
- informes por escenario;
- lista de issues;
- informes de retest;
- matriz final de cumplimiento;
- informe ejecutivo;
- registro de limitaciones y riesgos residuales;
- actualización de procedimientos;
- aceptación formal del propietario.
El informe ejecutivo debe traducir los resultados técnicos en condiciones de decisión: aprobado, aprobado con restricciones, retest requerido o no aprobado.
Errores comunes
Tratar el IST como demostración
Una presentación ensayada, sin criterios previos y sin registro de datos, no demuestra desempeño.
Comenzar antes del readiness
Las pruebas integradas no deben compensar pendientes de instalación, lógica o documentación.
Probar solamente energía
La continuidad eléctrica no garantiza climatización, control, comunicación, seguridad o recuperación.
Usar scripts genéricos
El escenario debe reflejar la arquitectura y los requisitos reales del emprendimiento.
Ignorar el estado degradado
La pérdida de redundancia puede ser operacionalmente crítica incluso sin desconexión inmediata.
No probar la restauración
El retorno al estado normal puede introducir nuevas fallas y debe formar parte del escenario.
Registrar solamente el resultado final
La secuencia temporal y las condiciones intermedias son esenciales para la evaluación.
Modificar lógica durante la prueba sin control
Cualquier modificación debe registrarse, analizarse y someterse a retest.
Aceptar intervención manual no prevista
Una acción correctiva improvisada durante el escenario puede ocultar una falla de diseño o automatización.
Excluir a operación
El equipo que recibirá el activo debe participar en la preparación, ejecución, debriefing y actualización de los procedimientos.
Checklist ejecutivo
Antes del IST, confirme:
- ¿los requisitos están aprobados y son trazables?
- ¿los sistemas individuales concluyeron las pruebas previstas?
- ¿los diagramas y secuencias reflejan el campo?
- ¿la punch list fue clasificada?
- ¿no existen pendientes que invaliden el escenario?
- ¿la configuración inicial está registrada?
- ¿los instrumentos están calibrados?
- ¿los relojes están sincronizados?
- ¿BMS, EPMS y DCIM registran tendencias y eventos?
- ¿los criterios de aceptación están definidos?
- ¿los criterios de aborto están claros?
- ¿el plan de restauración fue revisado?
- ¿los responsables están presentes?
- ¿la autoridad de inicio y aborto está definida?
- ¿los fabricantes aprobaron el método de falla o simulación?
- ¿los riesgos de seguridad fueron controlados?
Durante la prueba, confirme:
- ¿cada acción fue ejecutada conforme al script?
- ¿las respuestas fueron observadas por todas las disciplinas?
- ¿los tiempos fueron registrados?
- ¿las intervenciones no previstas fueron documentadas?
- ¿el estado degradado permaneció estable?
- ¿la carga crítica y las condiciones ambientales fueron preservadas?
- ¿las alarmas fueron correctas y comprensibles?
- ¿el equipo reconoció la condición?
Después de la prueba, confirme:
- ¿el estado normal fue restaurado?
- ¿la redundancia fue recompuesta?
- ¿se eliminaron bypasses, inhibiciones y lógicas temporales?
- ¿los datos fueron preservados?
- ¿se abrieron issues?
- ¿se realizó el debriefing?
- ¿se definió el retest necesario?
- ¿el propietario registró la aceptación?
Conclusión
Las Pruebas Integradas de Sistemas en Data Centers son la etapa en la que la infraestructura deja de evaluarse como un conjunto de equipos independientes y pasa a verificarse como un sistema crítico. Su valor está en revelar fallas de interfaz, dependencias ocultas, tiempos inadecuados, alarmas inconsistentes, limitaciones de capacidad y dificultades de recuperación antes de que estas condiciones provoquen indisponibilidad real.
Un IST técnicamente robusto exige requisitos trazables, sistemas previamente probados, configuración controlada, escenarios orientados a riesgo, scripts detallados, instrumentación adecuada, sincronización temporal, criterios de aborto, procedimientos de restauración, gestión de issues y aceptación formal.
A3A Engenharia actúa en la planificación, revisión, acompañamiento y documentación de pruebas integradas en Data Centers, conectando requisitos, diseño, ejecución, operación y criterios de aceptación para producir evidencias independientes sobre el readiness de la infraestructura crítica.
Referencias técnicas
[3] UPTIME INSTITUTE. Data Center Site Infrastructure Tier Standard: Operational Sustainability.
[4] UPTIME INSTITUTE. Data Center Site Infrastructure Tier Standard: Topology.
[5] ISO; IEC. ISO/IEC TS 22237-7 — Information technology — Data centre facilities and infrastructures — Part 7: Management and operational information.
[6] ABNT. ABNT NBR 17207:2025 — Sistemas de ventilación y climatización en entornos de tecnología de la información, comunicación y Data Center.
[7] ABNT. ABNT ISO/IEC TS 22237-5:2024 — Tecnología de la información — Instalaciones e infraestructuras de Data Center — Parte 5: Infraestructura de cableado de telecomunicaciones.
[8] ABNT. ABNT NBR 17240 — Sistemas de detección y alarma de incendios — Diseño, instalación, commissioning y mantenimiento de sistemas de detección y alarma de incendios — Requisitos.
Preguntas frecuentes
Es una prueba orientada a escenarios que verifica si diferentes sistemas e interfaces responden de forma coordinada a condiciones normales, degradadas, de falla, mantenimiento o emergencia, preservando la función crítica y produciendo evidencias trazables.
No. La prueba funcional verifica un sistema o disciplina. El IST evalúa la interacción entre energía, climatización, automatización, telecomunicaciones, seguridad, incendios y operación durante un evento común.
En muchos programas de commissioning, sí. Sin embargo, la numeración L1–L5 no es universal y debe definirse en el plan y en el contrato. El contenido técnico de la prueba es más importante que la etiqueta.
Requisitos y documentos actualizados, sistemas individuales probados, pendientes críticos cerrados, configuración controlada, instrumentos calibrados, sistemas supervisores operativos, equipo definido, criterios de aceptación y plan de restauración aprobados.
No en todos los casos. Cuando la falla real no pueda provocarse con seguridad o sin riesgo desproporcionado, puede utilizarse una simulación autorizada, siempre que se demuestren su representatividad y limitaciones.
Depende del escenario. Pueden participar energía, UPS, baterías, generadores, climatización, automatización, BMS, EPMS, DCIM, telecomunicaciones, red, incendios, control de acceso, seguridad y el propio equipo operacional.
Los criterios deben derivar de los requisitos e incluir respuestas funcionales, tiempos, capacidad remanente, condiciones ambientales, alarmas, registros, actuación del equipo, estabilidad y retorno al estado normal.
No. El escenario puede ser rechazado por sobrecarga, pérdida de monitoreo, actuación manual no prevista, respuesta térmica inadecuada, alarmas incorrectas, inestabilidad o imposibilidad de restauración segura.
Sí. El equipo operacional debe revisar los escenarios, acompañar o ejecutar maniobras, interpretar alarmas, participar en la restauración e incorporar los resultados a SOPs, MOPs y EOPs.
Plan y matriz de escenarios, scripts, registros de ejecución, datos brutos, tendencias, informes, lista de issues, evidencias de retests, matriz de cumplimiento, riesgos residuales y aceptación formal del propietario.
Materiales técnicos complementarios
- Commissioning de Data Center: pruebas, niveles y criterios de aceptación
- Recommissioning de Data Center después de expansión o modernización
- Commissioning y Aceptación de Data Centers
- Mantenimiento concurrente en Data Centers: qué significa y cómo verificarlo
- MOP, SOP y EOP en Data Centers: diferencias y cómo estructurar procedimientos
- Principales causas de indisponibilidad en Data Centers
- Sostenibilidad operacional en Data Centers: cómo preservar la resiliencia
- Arquitectura eléctrica de Data Center: N, N+1, 2N y distribución A/B
- DCIM, BMS y EPMS en Data Centers: diferencias, integración y arquitectura
