Entenda como estruturar manutenção de rede com criticidade, baseline, prevenção, diagnóstico, certificação, monitoramento, PoE, Wi-Fi, mudanças e adequação.
Confira!
Manutenção de rede é o conjunto de atividades usadas para preservar disponibilidade, desempenho, segurança operacional e rastreabilidade da infraestrutura de comunicação ao longo do ciclo de vida. Em uma rede corporativa, isso envolve muito mais do que substituir cabos ou reiniciar equipamentos: é necessário conhecer ativos, dependências, criticidade, baseline de desempenho, histórico de falhas, condição do cabeamento, capacidade dos switches, PoE, backbone, Wi-Fi, documentação e configuração.
A estratégia correta combina ações preventivas, corretivas e baseadas em condição de acordo com o modo de falha e o impacto de cada componente. Quando a mesma falha retorna, a manutenção deixa de ser apenas execução e passa a exigir diagnóstico de causa raiz e, frequentemente, engenharia de adequação.
O que é manutenção de rede?
Manutenção de rede abrange atividades sobre componentes passivos e ativos.
Na infraestrutura passiva entram cabeamento de cobre, fibra óptica, conectores, patch panels, patch cords, DIOs, racks, organizadores, caminhos, identificação e documentação. Na infraestrutura ativa entram switches, roteadores, access points, controladoras, firewalls, transceptores, fontes, UPS e demais equipamentos que sustentam comunicação.
A manutenção também precisa considerar serviços lógicos — VLANs, roteamento, DHCP, DNS, autenticação, monitoramento e configurações — porque uma rede fisicamente íntegra pode continuar indisponível por falha de configuração ou serviço.
Manutenção corretiva, preventiva e baseada em condição
As estratégias não são concorrentes. Cada uma atende a um tipo de risco.
Manutenção corretiva
É executada depois da falha. Pode ser apropriada para componentes de baixa criticidade, com reposição simples e baixo impacto. Em sistemas críticos, entretanto, depender apenas de corretiva aumenta exposição a downtime e pode prolongar recuperação quando não há sobressalente, documentação ou diagnóstico.
Manutenção preventiva
É planejada por periodicidade, uso ou política. Em redes, pode incluir inspeção de racks, verificação de ventilação, revisão de identificação, limpeza apropriada de conectores ópticos, conferência de backups de configuração, revisão de alarmes, testes de redundância e checagem de capacidade.
A periodicidade deve ter justificativa. Executar uma rotina porque “sempre foi mensal” sem relação com modo de falha, criticidade ou condição pode consumir recursos sem reduzir risco.
Manutenção baseada em condição
Usa evidências para decidir intervenção. Monitoramento de erros de porta, utilização de uplinks, potência óptica, temperatura, PoE, eventos de failover, saúde de fontes e outros indicadores ajudam a identificar degradação antes da falha funcional.
Essa abordagem é particularmente útil em ativos que fornecem sinais mensuráveis de deterioração ou sobrecarga.
Comece pelo cadastro e pela criticidade
É difícil manter aquilo que não está identificado. Uma rede sem inventário confiável transforma cada intervenção em investigação.
O cadastro pode relacionar:
- racks e salas técnicas;
- switches e módulos;
- portas e uplinks;
- patch panels e DIOs;
- enlaces de cobre e fibra;
- access points;
- fontes e UPS;
- links WAN;
- servidores de rede relevantes;
- contratos, licenças e garantias;
- versões de software/firmware quando aplicável;
- dependências entre ativos e sistemas.
Depois, classifique criticidade. Um switch de acesso de uma sala administrativa não tem necessariamente o mesmo impacto de um core, de um switch que alimenta dezenas de câmeras ou de um enlace que conecta uma unidade inteira.
Criticidade ajuda a definir sobressalentes, monitoramento, prioridade de atendimento, periodicidade de revisão e estratégia de redundância.
Baseline: a referência para manutenção e diagnóstico
A baseline representa como a rede funciona em condição conhecida e aceitável. Sem ela, a equipe percebe desvios apenas quando usuários reclamam.
Uma baseline pode registrar:
- utilização normal de uplinks;
- latência interna;
- perda de pacotes;
- erros de interface;
- disponibilidade de ativos;
- consumo e reserva de PoE;
- clientes por AP;
- temperatura de equipamentos;
- potência óptica quando monitorável;
- eventos de failover;
- histórico de incidentes;
- capacidade instalada e reserva.
O valor está na comparação. Se um uplink operava tipicamente com determinada utilização e começa a permanecer próximo da saturação, há um sinal de mudança de condição. Se erros de interface passam a crescer, a equipe possui um indicador antes que a falha se torne total.
Quando a rede não tem documentação confiável
Se a organização não possui baseline, inventário ou documentação coerente com o campo, criar apenas um calendário de manutenção perpetua a incerteza. O primeiro passo é descobrir a condição real, riscos e prioridades da infraestrutura.
Em instalações antigas, o primeiro serviço de manutenção pode precisar ser um levantamento técnico. Plantas, planilhas de portas e etiquetas podem estar desatualizadas; cabos podem ter sido remanejados; switches podem ter sido substituídos; VLANs podem ter mudado.
Nessa situação, simplesmente criar um calendário de inspeção mantém a incerteza. É mais consistente reconstruir a baseline e reconciliar campo com documentação.
O levantamento deve identificar o que existe e a Due Diligence deve interpretar riscos, limitações, capacidade, obsolescência e criticidade. Esse diagnóstico estabelece quais rotinas de manutenção realmente fazem sentido.
O plano de manutenção deve nascer dos modos de falha
A pergunta correta não é “qual manutenção fazemos nesse switch?”, mas “de que maneiras a função desse ativo pode ser perdida e quais sinais antecedem essa perda?”.
Exemplos:
| Ativo/elemento | Modo de falha | Evidência possível | Ação de manutenção |
| enlace de cobre | terminação degradada | erros, renegociação, FAIL em certificação | inspeção, teste, reterminação |
| fibra | conector contaminado | aumento de perda, potência baixa | inspeção, limpeza, medição |
| switch | fonte ou ventilação | alarmes, temperatura, falha de PSU | revisão, substituição planejada |
| uplink | saturação | utilização e drops | capacidade/arquitetura |
| AP | PoE insuficiente | reinícios, eventos de potência | verificar budget, porta e canal |
| configuração | mudança incorreta | logs, divergência de baseline | rollback/revisão controlada |
Essa lógica impede que a manutenção se transforme em checklist genérico desconectado do risco real.
Racks e salas técnicas: manutenção começa pelo ambiente
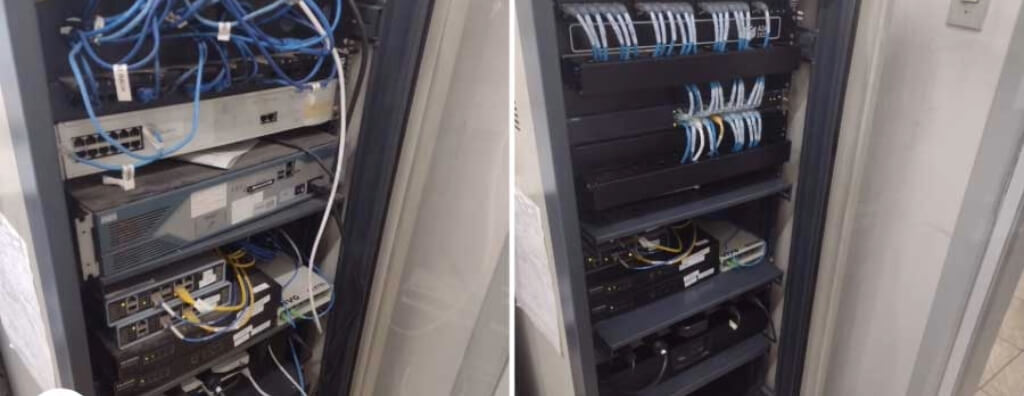
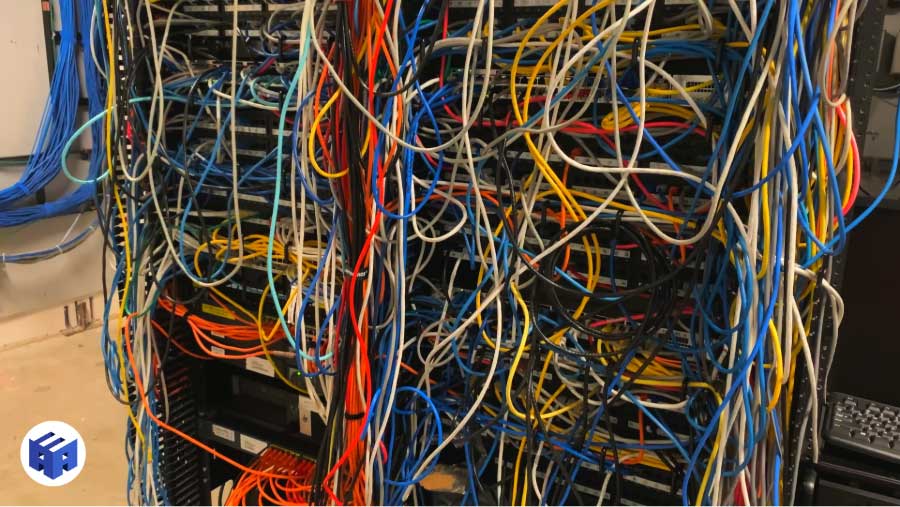
Racks desorganizados aumentam tempo de intervenção e risco de erro humano. A manutenção deve verificar organização, identificação, ventilação, ocupação, energia, UPS, patching e acessibilidade.
Pontos importantes:
- cabos não devem bloquear ventilação;
- patch cords devem ter comprimento e roteamento adequados;
- portas e painéis precisam de identificação coerente;
- equipamentos pesados devem estar instalados com suporte adequado;
- fontes e PDUs precisam ser conhecidas e documentadas;
- expansão deve respeitar reserva física e térmica;
- acessos ao rack precisam ser controlados conforme criticidade.
Cabeamento de cobre: o que inspecionar
Cabeamento estruturado passivo possui longa vida útil quando bem projetado e instalado, mas pode ser degradado por intervenções, curvaturas, tração, esmagamento, umidade, calor, conectores danificados e terminações refeitas sem controle.
A manutenção deve observar:
- integridade aparente dos cabos e conectores;
- identificação dos pontos;
- estado dos patch cords;
- organização em patch panels;
- presença de emendas ou improvisações;
- raio de curvatura e esforços mecânicos visíveis;
- proximidade inadequada de fontes de interferência;
- ocupação de caminhos;
- coerência entre campo e documentação.
Inspeção visual identifica alguns problemas, mas não comprova desempenho elétrico do enlace.
Quando certificar novamente o cabeamento
Não é necessário certificar toda a rede em cada visita de manutenção apenas por rotina. A decisão deve ser orientada por risco e evidência.
Certificação é particularmente útil quando:
- há falhas intermitentes em pontos específicos;
- a velocidade negociada caiu;
- houve obra ou remanejamento;
- terminações foram refeitas;
- não existe relatório original;
- a rede será reutilizada em uma expansão;
- há mudança de aplicação ou requisito;
- é necessário comprovar condição antes/depois de intervenção.
O teste deve usar configuração e limite adequados, como Permanent Link, Channel ou MPTL, conforme o objeto analisado.

Continuidade, qualificação e certificação são coisas diferentes
Um testador simples pode verificar continuidade e mapa de fios. Ferramentas de qualificação podem estimar capacidade para determinadas aplicações. Certificadores medem parâmetros normalizados do enlace contra limites definidos.
Confundir esses níveis gera laudos frágeis. Se o objetivo é comprovar que um enlace atende à categoria/classe contratada, o processo precisa ser compatível com certificação, e não apenas com continuidade.
Fibra óptica exige limpeza e método de teste
Conectores ópticos contaminados são causa recorrente de perda e instabilidade. A manutenção deve adotar inspeção e limpeza adequadas antes de medições e reconexões.
Quando houver suspeita de degradação, os testes podem envolver medição de perda por LSPM/OLTS e OTDR conforme o objetivo. OTDR é útil para localizar eventos; não deve ser tratado automaticamente como substituto de uma medição de perda extremo a extremo.
Também devem ser registrados tipo de fibra, conectores, transceptores, potência, rotas e reservas disponíveis.
Switches: manter disponibilidade e capacidade
Manutenção de switches não se resume a firmware. É necessário avaliar a função do equipamento na arquitetura.
Indicadores e verificações podem incluir:
- CPU e memória;
- temperatura;
- fontes e ventiladores;
- erros de interface;
- flaps;
- utilização de portas e uplinks;
- STP e mudanças de topologia;
- LACP e estado de membros;
- PoE utilizado/disponível;
- redundância;
- logs e alarmes;
- backups de configuração;
- versão e ciclo de suporte do fabricante.
Atualização de software precisa seguir gestão de mudanças, avaliação de compatibilidade, backup, janela e plano de retorno.
Obsolescência e fim de suporte
Equipamento funcionando não significa ativo sustentável. Fim de suporte pode afetar disponibilidade de peças, atualizações de segurança, licenças, compatibilidade e tempo de recuperação.
O plano de manutenção deve manter visão de ciclo de vida:
- data de aquisição;
- cobertura de suporte;
- disponibilidade de sobressalentes;
- versões suportadas;
- dependências de licença;
- compatibilidade com novos equipamentos;
- risco de falha e impacto operacional.
Substituições podem ser planejadas antes de uma falha crítica, evitando compras emergenciais.
PoE precisa ser mantido como sistema de potência
Access points, câmeras, telefones e controladores podem depender integralmente do PoE. A expansão gradual desses dispositivos pode consumir a margem do switch sem que a equipe perceba.
O plano deve acompanhar:
- consumo por porta;
- orçamento total;
- fontes instaladas;
- redundância;
- carga máxima dos dispositivos;
- capacidade da UPS;
- eventos de potência;
- temperatura do rack;
- condição dos canais de cobre.
Uma câmera que reinicia em determinados momentos pode estar recebendo potência insuficiente mesmo que o link Ethernet aparente estar normal.
Wi-Fi: manutenção não é apenas reiniciar AP
A rede wireless muda ao longo do tempo: layout, mobiliário, densidade de usuários, dispositivos vizinhos, aplicações e interferência alteram as condições de RF.
Manutenção pode envolver:
- análise de clientes por AP;
- utilização e airtime;
- canais e potência;
- interferência;
- SNR;
- falhas de autenticação;
- roaming;
- estado do uplink;
- PoE;
- capacidade dos switches;
- revisão de cobertura após mudanças físicas.
Adicionar APs sem novo planejamento pode aumentar interferência e contenção. Quando o ambiente mudou de forma relevante, o correto pode ser refazer parte do projeto de RF.
Configuração e backup também são ativos
Uma rede pode levar horas para recuperar um equipamento substituído se não houver backup confiável de configuração.
A manutenção deve definir:
- frequência e método de backup;
- controle de versões;
- armazenamento protegido;
- acesso autorizado;
- procedimento de restauração;
- registro de mudanças;
- documentação das dependências.
Backups precisam ser testáveis. Arquivo existente não garante que a restauração esteja compreendida ou que credenciais e licenças necessárias estejam disponíveis.
Gestão de mudanças reduz falhas induzidas
Uma parcela dos incidentes surge durante expansão, atualização ou correção. Por isso, manutenção precisa de processo de mudança.
Uma mudança relevante deve registrar:
- objetivo;
- ativos afetados;
- configuração anterior;
- passos de execução;
- risco;
- janela;
- rollback;
- responsável;
- testes pós-mudança;
- atualização de documentação.
Em redes críticas, mudanças emergenciais também precisam ser registradas posteriormente para que a baseline não se perca.
Monitoramento contínuo e observabilidade
Monitoramento não substitui manutenção, mas fornece condição para priorizá-la.
Indicadores úteis dependem da arquitetura, mas podem incluir:
- disponibilidade;
- utilização;
- erros de porta;
- descartes;
- latência;
- perda;
- temperatura;
- PoE;
- estado de fontes;
- vizinhança e topologia;
- eventos de failover;
- capacidade WAN;
- clientes Wi-Fi;
- falhas de serviços críticos.
Alertas precisam ser acionáveis. Uma plataforma com milhares de alarmes sem criticidade definida apenas desloca o problema para a equipe de operação.
Indicadores de manutenção de rede
KPIs devem apoiar decisão, não decorar painel.
Alguns exemplos:
- disponibilidade por serviço ou domínio;
- número de incidentes recorrentes;
- MTTR;
- tempo entre falhas relevantes;
- backlog de correções;
- percentual de ativos sem documentação;
- percentual de enlaces críticos com evidência de teste;
- utilização de uplinks críticos;
- reserva de PoE;
- quantidade de equipamentos fora de suporte;
- taxa de mudanças com rollback ou incidente.
A tendência é mais útil do que um valor isolado. Um MTTR crescente, por exemplo, pode revelar documentação pior, maior complexidade ou falta de sobressalentes.
Sobressalentes e estratégia de reposição
Nem todo equipamento exige spare local. A decisão depende de criticidade, prazo de reposição, redundância e impacto.
Para ativos críticos, avalie:
- tempo aceitável de recuperação;
- existência de redundância;
- lead time de compra;
- compatibilidade do sobressalente;
- licenciamento;
- módulos/transceptores necessários;
- configuração pronta para restauração.
Um spare incompatível ou sem licença não reduz significativamente o tempo de recuperação.
Manutenção em redes brownfield
Em redes antigas, a equipe frequentemente convive com camadas sucessivas de expansão. Existem cabos de diferentes categorias, switches de gerações distintas, patching alterado e documentação parcial.
A manutenção precisa distinguir três grupos:
- ativos adequados que podem permanecer;
- ativos que exigem correção localizada;
- limitações estruturais que pedem projeto de adequação.
Essa classificação evita dois extremos: substituir tudo sem necessidade ou perpetuar infraestrutura incapaz de atender novos requisitos.
Quando a manutenção vira projeto de adequação
Se a rotina identifica problemas que não podem ser resolvidos por intervenção pontual, a solução passa a ser engenharia de projeto.
Exemplos:
- uplinks permanentemente subdimensionados;
- backbone sem reserva;
- racks sem capacidade física/térmica;
- PoE sem margem;
- ausência de redundância em sistemas críticos;
- caminhos saturados;
- rede lógica com segmentação inadequada;
- Wi-Fi incompatível com a nova densidade;
- cabeamento incapaz de suportar a aplicação futura;
- equipamentos fora de suporte em pontos críticos.
O plano de manutenção deve transformar essas limitações em backlog de engenharia com criticidade, prioridade e investimento estimado.
Ensaios e testes após intervenções
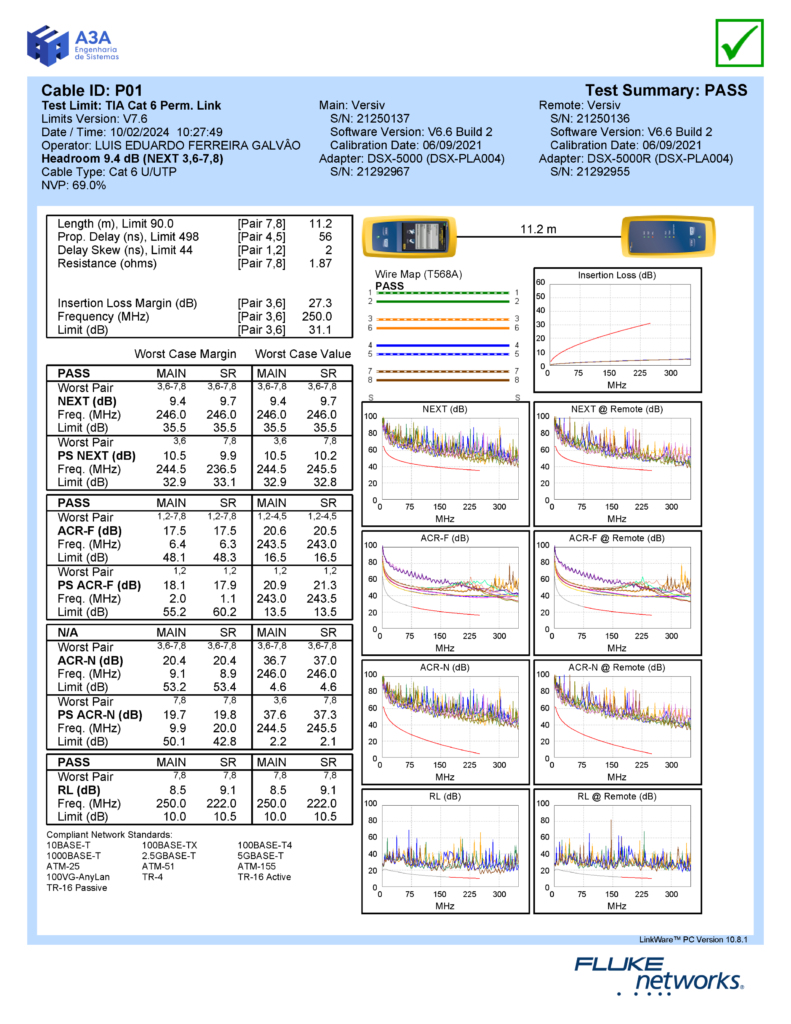
Uma correção só deve ser considerada encerrada quando o resultado pode ser comprovado. Ensaios de cabeamento, fibra, redundância, PoE e desempenho transformam manutenção em processo verificável, com evidência de antes e depois.
Uma correção deve ser comprovada.
Dependendo do escopo, podem ser necessários:
- certificação de enlaces;
- medição óptica;
- testes de redundância;
- failover;
- validação de PoE;
- teste de throughput;
- verificação de VLANs e roteamento;
- validação de Wi-Fi;
- monitoramento pós-mudança.
A evidência de antes e depois fecha o ciclo de manutenção e evita declarar sucesso apenas porque o usuário deixou de reclamar temporariamente.
Organização de documentação e As Built
Toda intervenção que altera condição real deveria atualizar o registro correspondente.
Isso pode incluir:
- mapa de portas;
- patching;
- planta de pontos;
- diagrama de backbone;
- inventário;
- configuração;
- endereçamento;
- VLANs;
- relatórios de teste;
- histórico de mudança.
Quando a documentação não acompanha a manutenção, a rede se torna gradualmente mais cara de diagnosticar.
Operação assistida após mudanças relevantes
Depois de migrações ou modernizações relevantes, a rede precisa provar estabilidade em operação real. A Operação Assistida acompanha indicadores, incidentes, pendências e transferência para a equipe responsável antes do encerramento técnico.
Grandes migrações, troca de core, redesenho de VLANs, substituição de backbone ou expansão de Wi-Fi podem exigir um período de operação assistida.
Nesse período, a equipe acompanha comportamento real, fecha pendências, ajusta parâmetros dentro do projeto aprovado, registra incidentes e transfere conhecimento para operação.
A operação assistida não deve ser um suporte indefinido. Precisa de critérios de entrada, indicadores, responsabilidades e condições de encerramento.
Contratação de manutenção: escopo precisa ser mensurável
Um contrato que exige apenas “manter a rede funcionando” cria ambiguidade. O escopo deve definir ativos cobertos, horários, criticidade, SLAs quando aplicáveis, exclusões, sobressalentes, documentação, atividades preventivas, monitoramento, testes e critérios de aceite.
Também é importante separar:
- suporte operacional;
- manutenção física;
- administração lógica;
- engenharia de diagnóstico;
- projetos de adequação;
- fornecimento de equipamentos.
Misturar tudo em uma única obrigação genérica dificulta medição e responsabilização.
Checklist técnico para estruturar o plano
Um plano de manutenção de rede pode começar pelas seguintes perguntas:
- existe inventário confiável?
- os ativos possuem criticidade definida?
- a topologia está atualizada?
- há backup de configuração?
- os enlaces críticos possuem evidência de teste?
- uplinks têm capacidade e margem?
- PoE possui reserva?
- redundâncias são testadas?
- a rede wireless possui baseline?
- existem equipamentos fora de suporte?
- há sobressalentes compatíveis com ativos críticos?
- mudanças são registradas?
- falhas recorrentes geram análise de causa raiz?
- documentação é atualizada após intervenção?
- indicadores mostram tendência de disponibilidade e incidentes?
Responder “não” a várias dessas perguntas indica que o problema não é apenas executar manutenção: é estruturar governança técnica da rede.
Considerações finais
Manutenção de rede deve preservar função, não apenas equipamentos. A estratégia eficaz conhece ativos e criticidade, usa baseline e monitoramento para detectar desvios, executa ações preventivas onde elas reduzem risco, diagnostica causa raiz nas falhas e transforma limitações estruturais em projetos de adequação.
A melhor manutenção é aquela que reduz recorrência e aumenta previsibilidade. Quando inspeções, testes, mudanças e documentação alimentam uma base técnica única, a organização deixa de reagir a incidentes isolados e passa a administrar a confiabilidade da rede como um ativo de engenharia.
Referências técnicas
[1] IEEE. IEEE 802.3 — Ethernet. Disponível em: https://standards.ieee.org/ieee/802.3/7071/
[2] ISO/IEC. ISO/IEC 11801-1:2017 — Information technology — Generic cabling for customer premises — Part 1: General requirements. Disponível em: https://www.iso.org/standard/66182.html
[3] IEC. IEC 61935-1:2019 — Specification for the testing of balanced and coaxial information technology cabling. Disponível em: https://webstore.iec.ch/en/publication/31201
[4] ABNT. ABNT NBR 14565 — Cabeamento estruturado para edifícios comerciais e data centers. Catálogo ABNT. Disponível em: https://www.abntcatalogo.com.br/
[5] ISO. ISO 55001 — Asset management — Asset management system — Requirements. Disponível em: https://www.iso.org/standard/83054.html
Perguntas frequentes
A corretiva ocorre após a falha. A preventiva é planejada para reduzir probabilidade ou impacto de modos de falha conhecidos. A estratégia deve considerar criticidade, condição e evidências.
Não necessariamente. A certificação deve ser orientada por risco, requisito e condição, por exemplo após intervenções, falhas recorrentes, ausência de relatório original ou necessidade de comprovar capacidade do enlace.
Depende da arquitetura, mas normalmente disponibilidade, utilização, erros de interface, uplinks, temperatura, PoE, fontes, failover, WAN, clientes Wi-Fi e serviços críticos.
Quando os problemas são estruturais, como capacidade insuficiente, PoE sem margem, backbone inadequado, falta de redundância, caminhos saturados, Wi-Fi incompatível com a demanda ou ativos críticos obsoletos.
Sim. Configuração é um ativo operacional. Backup, versionamento, acesso controlado e procedimento de restauração reduzem tempo de recuperação após falha ou substituição.
É um período controlado de acompanhamento após implantação ou migração relevante para observar comportamento, fechar pendências, ajustar parâmetros previstos e transferir conhecimento antes do encerramento.
Materiais técnicos complementares
Soluções relacionadas
Serviços relacionados
- Due Diligence Técnica de Engenharia
- Ensaios e Testes Técnicos
- Operação Assistida
- Projeto de Rede Lógica e Redes Corporativas
Conteúdos principais sobre o tema
- Troubleshooting de Redes: diagnóstico por camadas, causa raiz e correção
- Estabilidade e Desempenho de Rede: diagnóstico, causas e correção
