Guia técnico de troubleshooting de redes: diagnóstico por camadas, cabeamento, PoE, switching, VLANs, DHCP, DNS, firewall, Wi-Fi, WAN, causa raiz e correção.
Confira!
Troubleshooting de redes é o processo estruturado de identificar, isolar e corrigir falhas de conectividade, disponibilidade ou desempenho com base em evidências. O objetivo não é testar comandos aleatoriamente nem substituir equipamentos por tentativa e erro. É reduzir o domínio de falha, formular hipóteses, medir o comportamento da rede e comprovar a causa raiz antes de aplicar a correção.
Uma falha percebida como “a rede está lenta” pode nascer no cabeamento, em uma porta de switch, no PoE, em um uplink saturado, no Wi-Fi, em uma VLAN, no roteamento, no DNS, no DHCP, no firewall, no link WAN, no servidor ou na aplicação. Por isso, troubleshooting eficiente separa sintoma, causa e impacto e percorre a cadeia de comunicação de forma disciplinada.
O que é troubleshooting de rede?
Troubleshooting é uma atividade de diagnóstico técnico. Em redes pequenas, muitos incidentes podem ser resolvidos por uma equipe interna com ferramentas básicas. Em ambientes corporativos, industriais ou críticos, entretanto, a quantidade de camadas, fornecedores, dependências e caminhos torna necessário trabalhar com topologia, documentação, métricas, logs e instrumentos de teste.
A diferença entre uma correção pontual e um diagnóstico de engenharia está na rastreabilidade. Uma correção pontual pode restabelecer serviço; um diagnóstico de engenharia precisa explicar o que falhou, por que falhou, como foi comprovado, qual correção foi aplicada e como evitar recorrência.
Sintoma não é causa raiz
Usuários descrevem efeitos: lentidão, queda, vídeo travando, telefone sem áudio, câmera offline, página que não abre, autenticação que falha. Esses relatos são importantes, mas ainda não localizam o problema.
Alguns exemplos mostram a diferença:
| Sintoma | Causas possíveis |
| estação sem acesso | cabo, porta, VLAN, DHCP, autenticação, gateway, DNS |
| AP reiniciando | PoE, fonte do switch, cabo, firmware, temperatura |
| videoconferência instável | Wi-Fi, uplink, perda, jitter, WAN, firewall, aplicação |
| câmera intermitente | canal físico, PoE, switch, uplink, VMS, energia |
| transferência lenta | negociação, erros de interface, saturação, storage, servidor |
| vários setores fora | switch, uplink, core, energia, roteamento, serviço comum |
Trocar um patch cord pode resolver um sintoma, mas se o defeito for uma terminação marginal no enlace permanente, a falha tende a retornar.
Primeiro passo: delimitar o domínio de falha
O diagnóstico começa definindo a extensão do problema.
Perguntas simples reduzem drasticamente o campo de investigação:
- afeta um usuário, uma sala, um switch, um pavimento ou toda a organização?
- afeta cabeados e wireless ou somente um meio?
- afeta todos os serviços ou apenas uma aplicação?
- começou depois de uma mudança?
- ocorre continuamente ou em horários específicos?
- acompanha picos de utilização?
- existe correlação com energia, temperatura ou eventos de infraestrutura?
- todos os dispositivos afetados compartilham algum switch, uplink, VLAN, gateway ou serviço?
Quando várias falhas possuem um elemento comum, esse elemento se torna candidato prioritário. Esse raciocínio evita iniciar a análise pelo ponto mais visível, mas tecnicamente improvável.
Antes de alterar, colete evidências
Alterar configuração durante o diagnóstico pode destruir a evidência que permitiria localizar a causa. Antes de reiniciar switch, trocar rota, mover VLAN ou substituir equipamento, registre o estado.
Dependendo do incidente, a coleta pode incluir:
- horário de início e duração;
- usuários e sistemas afetados;
- topologia do caminho;
- status e velocidade das interfaces;
- contadores de erros e descartes;
- utilização de CPU e memória;
- utilização de uplinks;
- logs de sistema;
- eventos de spanning tree e LACP;
- estado do PoE;
- leases DHCP;
- consultas e respostas DNS;
- latência e perda em diferentes saltos;
- potência e qualidade de sinal Wi-Fi;
- alertas do firewall e links WAN;
- alterações recentes.
Um snapshot do estado pré-incidente também ajuda a comparar comportamento normal e anormal.
Baseline: saber o que é normal
Sem baseline, “está lento” vira uma comparação subjetiva. A baseline registra condições típicas para que um desvio seja mensurável.
Ela pode incluir:
- utilização típica dos uplinks;
- latência interna entre segmentos;
- perda de pacotes em condições normais;
- erros de interface;
- disponibilidade de equipamentos;
- potência PoE utilizada e disponível;
- clientes e airtime por AP;
- consumo por aplicação ou sistema;
- eventos de failover;
- incidentes recorrentes.
Depois da correção, as mesmas métricas ajudam a comprovar resultado. Baseline também permite detectar degradação gradual antes que se transforme em indisponibilidade.
Troubleshooting por camadas evita saltos de hipótese
Uma abordagem por camadas não significa seguir rigidamente o modelo OSI do nível 1 ao 7 em todos os casos. Significa testar primeiro as hipóteses coerentes com o sintoma, mantendo clareza sobre qual camada está sendo investigada.
Em redes corporativas, uma sequência prática costuma separar:
- energia e meio físico;
- interface Ethernet e switching;
- VLANs e camada 2;
- endereçamento e camada 3;
- serviços como DHCP, DNS e autenticação;
- segurança e políticas;
- WAN, servidores e aplicações;
- Wi-Fi, quando o acesso é sem fio.
O importante é não concluir que “o cabo está ruim” porque há perda, nem que “o firewall bloqueou” porque uma porta não responde, sem evidência correspondente.
Camada física: o problema pode existir antes do IP
A camada física inclui cabos, conectores, patch panels, patch cords, fibras, DIOs, interfaces, transceptores, alimentação, racks e caminhos.
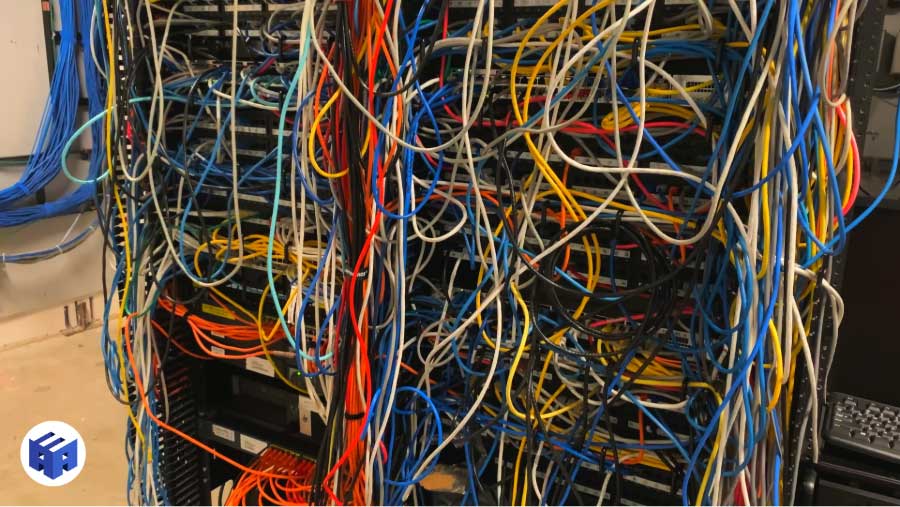
Falhas físicas podem produzir sintomas intermitentes difíceis de reproduzir. Um enlace pode estabelecer link e ainda apresentar margem insuficiente, erros, renegociação ou instabilidade sob determinadas condições.
Sinais que justificam investigação física incluem:
- velocidade negociada abaixo do esperado;
- link subindo e descendo;
- CRC/FCS ou outros erros de interface em crescimento;
- falha concentrada em um ponto ou conjunto de pontos;
- comportamento alterado após movimentação de patch cords;
- problemas associados a calor, umidade, vibração ou interferência;
- PoE instável;
- histórico de terminações improvisadas ou expansão sem controle.
Continuidade não é certificação
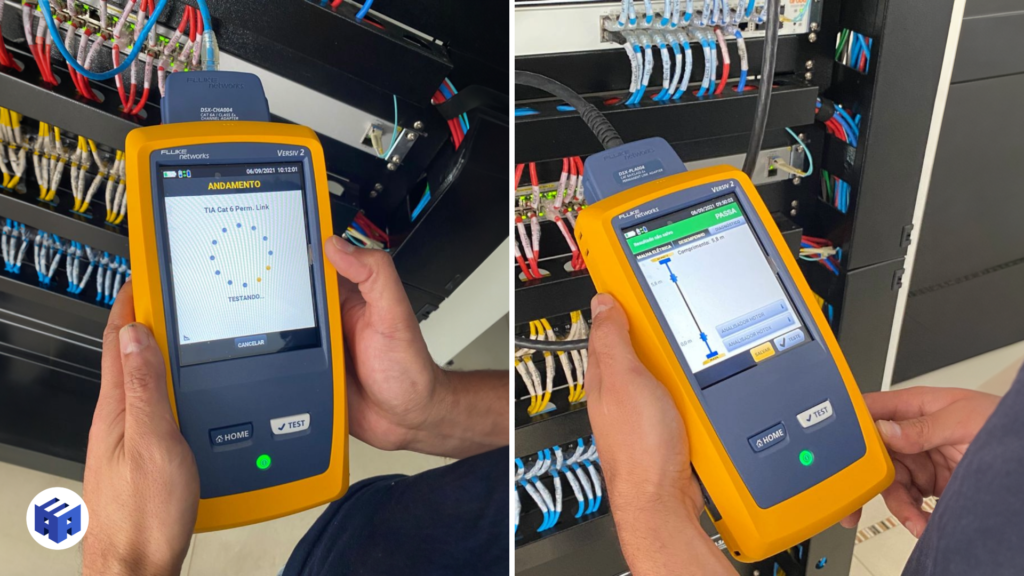
Um testador simples de continuidade verifica mapa básico de condutores e pode localizar circuitos. Isso não comprova que um enlace atende ao desempenho de uma categoria/classe.
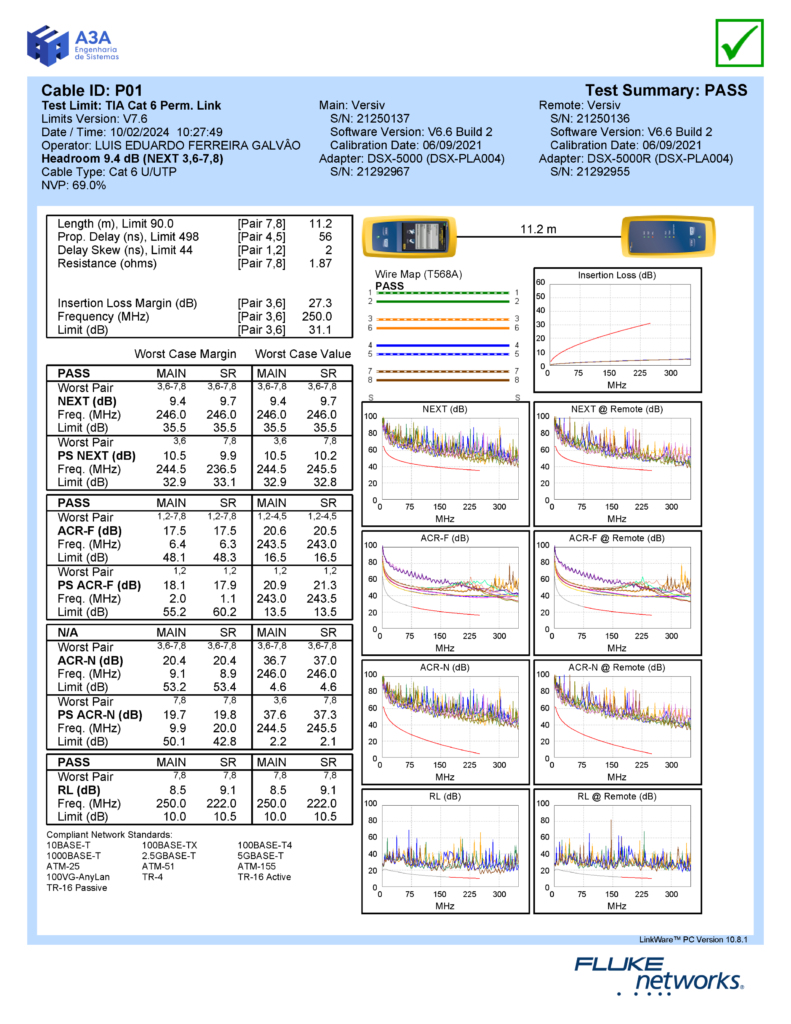
A certificação de cabeamento de cobre utiliza instrumento apropriado e limites definidos para a configuração ensaiada, como Permanent Link, Channel ou MPTL. Entre os parâmetros aplicáveis estão perda de inserção, NEXT, PSNEXT, perda de retorno, comprimento e outros previstos pelo limite selecionado.
Em troubleshooting, a certificação é útil quando existe suspeita de degradação física, instalação inadequada, alteração de componentes ou quando a organização não possui evidência confiável do desempenho do enlace.
PASS/FAIL não encerra o diagnóstico
Um resultado PASS indica aderência ao limite selecionado no momento do teste. Ele não prova que toda a rede lógica, o switch, o servidor ou a aplicação estão corretos.
Da mesma forma, um FAIL precisa ser interpretado. O parâmetro e a frequência em que ocorre a falha ajudam a direcionar investigação para terminação, comprimento, componente, conexão ou condição de instalação.
A margem também é relevante em diagnósticos comparativos: enlaces aprovados muito próximos do limite podem merecer atenção quando há histórico de intermitência, embora a decisão de intervenção deva considerar o conjunto das evidências.
Fibra óptica: continuidade visual não basta
Em backbone óptico, troubleshooting pode exigir inspeção e limpeza de conectores, medição de potência/perda e, quando aplicável, OTDR.
OLTS/LSPM e OTDR respondem perguntas diferentes. Medição de perda avalia desempenho extremo a extremo dentro do método definido; OTDR ajuda a localizar eventos ao longo do enlace. Um não deve ser tratado automaticamente como substituto do outro.
Antes de concluir que um transceptor está defeituoso, verifique limpeza, conectividade, orçamento óptico, compatibilidade, potência recebida e condição do enlace.
PoE cria uma dimensão elétrica no troubleshooting
Quando o dispositivo depende de Power over Ethernet, link de dados e alimentação compartilham o mesmo caminho. Um AP ou câmera que reinicia pode estar sofrendo problema de potência, não de protocolo.
A investigação deve considerar:
- padrão e classe PoE requeridos;
- potência solicitada pelo dispositivo;
- potência disponível por porta;
- orçamento total do switch;
- redundância de fontes;
- condição do cabeamento e conectores;
- comprimento do canal;
- eventos de sobrecorrente ou proteção;
- temperatura e ventilação do rack.
Problemas podem aparecer apenas em picos de consumo, boot, acionamento de recursos ou após expansão do número de dispositivos alimentados.
Interface Ethernet: contadores contam a história
Uma porta aparentemente “up” ainda pode indicar problema.
Observe, conforme a plataforma:
- velocidade e duplex negociados;
- erros de recepção e transmissão;
- CRC/FCS;
- drops e discards;
- flaps de link;
- utilização;
- pause frames quando disponíveis;
- erros do módulo óptico;
- temperatura e alarmes de transceiver;
- eventos PoE.
Contadores devem ser avaliados em janela de tempo. Um valor acumulado há anos é menos útil do que a taxa de crescimento durante o incidente.
Velocidade negociada abaixo do esperado
Uma estação prevista para 1 Gb/s operando em 100 Mb/s é um indício valioso. Pode haver problema em pares, terminação, patch cord, configuração ou capacidade do equipamento.
O diagnóstico deve confirmar:
- capacidade das duas interfaces;
- configuração de negociação;
- estado do canal físico;
- patch cords e conectores;
- erros de porta;
- histórico de flaps.
Forçar manualmente velocidade sem entender a causa pode esconder o problema e criar novas incompatibilidades.
Switching: VLAN, STP e LACP
Depois de verificar o acesso físico, a camada 2 passa a ser candidata.
VLANs
Uma porta pode ter link e mesmo assim não alcançar o destino se estiver na VLAN errada, se a VLAN não estiver permitida no trunk ou se houver inconsistência de tagging.
Compare configuração real com a arquitetura. Mudanças emergenciais acumuladas são causa comum de divergência entre documentação e produção.
Spanning Tree
Loops de camada 2 podem gerar tempestades, utilização elevada e instabilidade ampla. Eventos de topologia também podem indicar enlaces oscilando ou caminhos mudando repetidamente.
A análise deve observar topologia esperada, root bridge, portas bloqueadas/encaminhando, mudanças recentes e correlação temporal com o incidente.
LACP e agregação
Um port-channel pode permanecer ativo mesmo com membro defeituoso ou distribuição inadequada. Verifique estado dos membros, consistência de configuração, hashes, erros e capacidade efetivamente disponível.
Uplinks e oversubscription
Muitos problemas descritos como “lentidão da rede” são, na verdade, saturação em pontos de agregação.
Compare capacidade de acesso com uplinks e comportamento de tráfego. Oversubscription não é necessariamente erro; é uma decisão de engenharia que precisa ser coerente com simultaneidade e perfil das aplicações.
O diagnóstico deve observar picos, média, percentis quando disponíveis, descartes em fila, utilização de interfaces e horários de reclamação.
Endereçamento IP e gateway
Se a camada 2 está funcional, verifique configuração IP.
Perguntas básicas:
- o dispositivo recebeu endereço correto?
- máscara/prefixo está correto?
- gateway pertence à rede adequada?
- existe IP duplicado?
- a rota para o destino existe?
- o retorno segue caminho compatível?
O ping pode comprovar alcançabilidade, mas não determina sozinho qualidade de aplicação nem identifica automaticamente a causa de perda.
DHCP: investigar o processo completo
Um cliente sem endereço pode indicar indisponibilidade do servidor DHCP, relay incorreto, VLAN errada, escopo esgotado, política de segurança ou problema de camada 2.
O troubleshooting deve acompanhar a cadeia desde a solicitação do cliente até a oferta e concessão, considerando relay e alcance do serviço.
Atribuir endereço estático temporário pode ajudar a isolar a hipótese, mas não é correção definitiva para um problema de DHCP.
DNS: conectividade pode existir e o serviço parecer indisponível
Quando acesso por IP funciona e por nome não, DNS se torna candidato. Verifique servidor configurado, resposta, tempo de resolução, registros e caminho até o serviço.
Evite trocar indiscriminadamente o DNS corporativo por servidor público em produção. Ambientes internos podem depender de zonas privadas, autenticação e políticas que não existem fora da organização.
Roteamento: ida e volta importam
A existência de rota de ida não garante comunicação funcional. Caminhos assimétricos, políticas, VRFs e rotas específicas podem afetar retorno e inspeção de firewall.
Analise tabela de rotas, próximo salto, prefixos, métricas e alterações recentes. Traceroute pode ajudar a visualizar parte do caminho, mas respostas ICMP podem ser filtradas ou priorizadas de forma diferente do tráfego da aplicação.
Firewall: testar política sem desmontar segurança
O procedimento antigo de “desabilitar temporariamente o firewall para testar” é inadequado em ambientes produtivos. O diagnóstico deve usar logs, sessões, counters, políticas e captura controlada.
Verifique:
- origem e destino;
- porta/protocolo;
- zona ou interface;
- política correspondida;
- NAT quando aplicável;
- estado de sessão;
- inspeção de aplicação;
- autenticação;
- logs de deny/allow;
- retorno do tráfego.
Mudanças de teste devem ser planejadas, restritas e reversíveis.
Wi-Fi exige diagnóstico de RF e de rede cabeada
Um problema wireless pode estar no rádio, no cliente ou no uplink do AP.
O diagnóstico deve separar:
- cobertura;
- SNR;
- interferência;
- utilização de canal;
- airtime;
- taxa dos clientes;
- retransmissões;
- roaming;
- autenticação;
- DHCP;
- PoE do AP;
- velocidade da porta;
- uplink do switch.
Sinal forte não significa capacidade. Um AP pode apresentar RSSI adequado e ainda sofrer contenção, interferência ou gargalo no caminho cabeado.
Servidor ou aplicação também podem ser o gargalo
Se rede física, interfaces, switches, rotas e serviços estão estáveis, a aplicação precisa entrar na análise.
Storage, CPU, banco de dados, filas, limites de sessão, dependências externas e arquitetura da aplicação podem gerar lentidão percebida como “problema de rede”.
Um bom troubleshooting termina quando a evidência localiza a causa, mesmo que ela esteja fora da rede.
WAN e provedores externos
Internet e circuitos entre sites precisam ser analisados separadamente da LAN.
Compare latência e perda em diferentes pontos do caminho. Verifique interface local, CPE, circuito, roteamento e desempenho do provedor. Em links redundantes, confirme se failover ocorreu conforme esperado e se o caminho secundário possui capacidade suficiente.
Abrir chamado no provedor com horário, origem, destino, medições e evidências aumenta a qualidade da investigação em comparação com a descrição genérica “internet lenta”.
Mudanças recentes são uma fonte valiosa de hipótese
Incidentes que aparecem logo após alteração de switch, firmware, VLAN, patching, política de firewall, expansão de APs ou migração de servidores devem ser correlacionados com a mudança.
Isso não significa assumir automaticamente culpa da alteração, mas ela se torna hipótese prioritária. Gestão de mudanças e registro de configuração reduzem tempo de investigação porque permitem comparar estado anterior e atual.
O que a equipe interna pode fazer com segurança
Uma equipe de TI pode realizar verificações iniciais sem transformar o troubleshooting em intervenção descontrolada:
- confirmar extensão do impacto;
- registrar horário e sintomas;
- testar outro ponto conhecido como bom;
- verificar status da porta;
- consultar logs e monitoramento;
- validar IP, gateway e DNS;
- confirmar associação e parâmetros Wi-Fi;
- correlacionar com mudanças;
- registrar evidências antes de alterar.
Ações que afetam múltiplos usuários — reboot de core, mudança de roteamento, alteração de firewall, desativação de redundância — precisam de avaliação de impacto, janela e rollback.
Quando é necessário diagnóstico especializado?
Quando o incidente atravessa várias camadas, reaparece depois de correções locais ou a infraestrutura não possui documentação confiável, o próximo passo não deve ser trocar equipamentos: deve ser construir evidência e priorizar riscos.
Escalone quando o incidente é recorrente, afeta sistemas críticos, cruza várias disciplinas ou não pode ser isolado com ferramentas operacionais.
Sinais claros incluem:
- falhas físicas intermitentes;
- suspeita de cabeamento sem certificação;
- backbone óptico com perda ou eventos desconhecidos;
- PoE instável;
- ausência de documentação;
- arquitetura com múltiplos pontos únicos de falha;
- problemas que reaparecem após correções paliativas;
- necessidade de medir e provar causa antes de investimento.
Nesses casos, o diagnóstico pode incluir levantamento, Due Diligence, certificação, medições, análise de logs, revisão de arquitetura e plano de adequação.
Certificação como ferramenta de diagnóstico
Suspeita de falha física precisa ser medida. Ensaios e testes técnicos permitem verificar enlaces, fibras e condições de desempenho com critérios documentados, transformando percepção de instabilidade em evidência de engenharia.
Quando o problema está associado ao meio físico, certificar enlaces selecionados ou todo o sistema pode transformar hipótese em evidência.
O plano deve definir limite, configuração de teste, identificação, instrumento, calibração, tratamento de FAIL e formato dos arquivos. Misturar Permanent Link e Channel sem registrar o que foi ensaiado prejudica a interpretação.
Matriz de sintomas e testes prioritários
| Sintoma | Primeiras evidências | Próxima ação se persistir |
| uma estação cai | link, porta, patch cord, IP | certificação do enlace / análise de configuração |
| várias estações do mesmo switch | uplink, CPU, energia, STP | analisar switch e dependências |
| AP reinicia | PoE, logs, porta, potência | testar canal, budget e switch |
| voz com cortes | perda, jitter, filas, Wi-Fi/WAN | localizar segmento com degradação |
| apenas nomes falham | DNS e alcance do servidor | analisar consultas e registros |
| apenas internet falha | gateway, firewall, WAN | comparar LAN x circuito externo |
| toda uma VLAN falha | trunk, SVI/gateway, política | revisar camada 2/3 e mudanças |
| desempenho piora em horário de pico | utilização e drops | capacidade, QoS e arquitetura |
Essa matriz não substitui engenharia; organiza a sequência de hipóteses.
Troubleshooting e MTTR
MTTR é influenciado não apenas pela capacidade técnica da equipe, mas pela observabilidade e documentação.
Se ninguém sabe qual tomada corresponde a qual porta, qual uplink atende determinado rack ou qual VLAN pertence a um sistema, cada incidente começa reconstruindo a rede. Isso aumenta indisponibilidade.
Identificação, topologia, mapa de portas, inventário, monitoramento e baseline reduzem o tempo necessário para localizar a falha e permitem que especialistas avancem diretamente para hipóteses relevantes.
Causa raiz x correção paliativa
Uma porta reiniciada e um serviço restabelecido não provam correção definitiva.
Depois de recuperar operação, pergunte:
- qual evidência explica a falha?
- por que ela ocorreu agora?
- existe outro ponto sujeito ao mesmo mecanismo?
- a correção elimina a causa ou apenas o sintoma?
- é necessário projeto de adequação?
- a documentação precisa ser atualizada?
- alguma métrica deve ser monitorada daqui em diante?
Esse processo transforma incidentes em melhoria de engenharia.
Problemas recorrentes indicam necessidade de adequação
Quando a causa raiz está em topologia, capacidade, segmentação, redundância ou desenho de switching, repetir troubleshooting não resolve o mecanismo da falha. A correção definitiva passa a ser um projeto de rede.
Se os mesmos sintomas retornam, pode existir limitação estrutural: cabeamento degradado, uplink subdimensionado, topologia inadequada, PoE insuficiente, ausência de redundância, VLANs acumuladas sem governança ou ativos sem capacidade.
Nesse cenário, troubleshooting deve gerar um plano de ação e, quando necessário, um projeto de adequação. Continuar realizando correções locais aumenta custo operacional e mantém risco.
Pós-incidente: registrar o que foi aprendido
Um registro de causa raiz pode conter:
- incidente e impacto;
- início, detecção e recuperação;
- evidências coletadas;
- causa imediata;
- causa raiz;
- fatores contribuintes;
- correção aplicada;
- ações preventivas;
- responsáveis e prazos;
- atualização de documentação;
- indicadores que passarão a ser monitorados.
Esse histórico evita repetir investigação e permite identificar padrões.
Considerações finais
Troubleshooting de rede é um processo de engenharia de diagnóstico. Quanto maior a criticidade, menos espaço existe para tentativa e erro. A abordagem correta delimita o domínio de falha, preserva evidências, testa hipóteses, mede a rede por camadas e só então aplica a correção.
A rede mais fácil de diagnosticar é aquela que já possui identificação, documentação, baseline e monitoramento. Quando problemas recorrentes passam a gerar evidência, causa raiz e plano de adequação, a organização deixa de apenas reagir a incidentes e começa a aumentar confiabilidade de forma estruturada.
Referências técnicas
[1] IEEE. IEEE 802.3 — Ethernet. Disponível em: https://standards.ieee.org/ieee/802.3/7071/
[2] ISO/IEC. ISO/IEC 11801-1:2017 — Information technology — Generic cabling for customer premises — Part 1: General requirements. Disponível em: https://www.iso.org/standard/66182.html
[3] IEC. IEC 61935-1:2019 — Specification for the testing of balanced and coaxial information technology cabling. Disponível em: https://webstore.iec.ch/en/publication/31201
[4] IETF. RFC 2131 — Dynamic Host Configuration Protocol. Disponível em: https://datatracker.ietf.org/doc/html/rfc2131
[5] IETF. RFC 1034 — Domain Names — Concepts and Facilities. Disponível em: https://datatracker.ietf.org/doc/html/rfc1034
[6] ABNT. ABNT NBR 14565 — Cabeamento estruturado para edifícios comerciais e data centers. Catálogo ABNT. Disponível em: https://www.abntcatalogo.com.br/
Perguntas frequentes
Definir o sintoma e delimitar o domínio de falha: quem é afetado, quais sistemas compartilham o problema, quando começou e quais elementos são comuns aos dispositivos impactados.
Não. Ping ajuda a testar alcançabilidade e latência ICMP, mas não comprova sozinho desempenho da aplicação, qualidade do cabeamento, DNS, políticas de firewall ou capacidade de uplinks.
Não. Continuidade verifica principalmente mapa de condutores. Certificação mede parâmetros do enlace contra limites técnicos da categoria/classe e configuração de teste aplicável.
Quando há renegociação de velocidade, flaps, erros de interface, intermitência localizada, PoE instável, histórico de terminações problemáticas ou ausência de evidência de certificação.
Em produção, isso não deve ser a estratégia padrão. Prefira logs, sessões, counters, captura e regras de teste controladas, com avaliação de impacto e rollback.
Quando incidentes são recorrentes, a causa está em limitações estruturais de capacidade, arquitetura, PoE, cabeamento, redundância ou documentação e correções pontuais não eliminam o mecanismo da falha.
Materiais técnicos complementares
Soluções relacionadas
Serviços relacionados
- Due Diligence Técnica de Engenharia
- Ensaios e Testes Técnicos
- Projeto de Rede Lógica e Redes Corporativas
- Consultoria Cisco para diagnóstico, projeto e modernização de redes
