Entenda servidores proxy, forward e reverse proxy, HTTPS, TLS, autenticação, cache, DMZ, alta disponibilidade, dimensionamento, migração e critérios de projeto.
Confira!
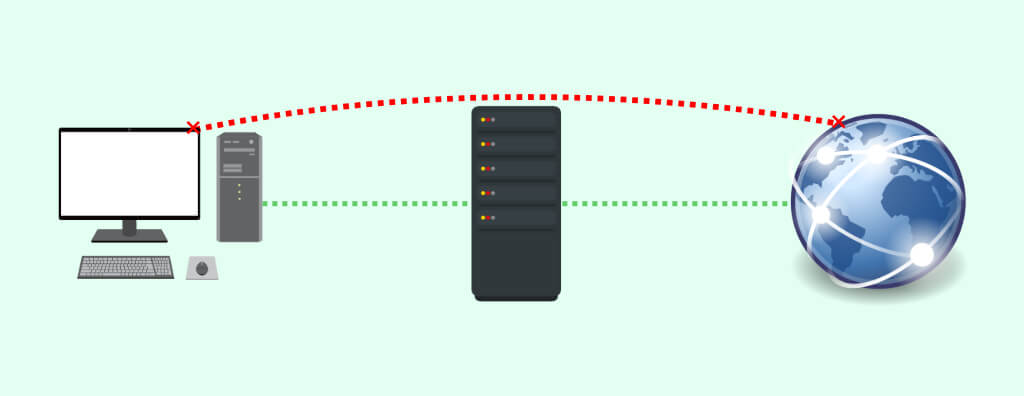
Um servidor proxy é um intermediário entre um cliente e outro serviço de rede. Em vez de o cliente se comunicar diretamente com o destino, a conexão passa pelo proxy, que pode encaminhar, filtrar, registrar, autenticar, armazenar em cache, inspecionar ou aplicar políticas ao tráfego. Em ambientes corporativos, proxies aparecem em navegação Web, publicação de aplicações, segurança, integração entre redes, acesso remoto e arquiteturas de data center e nuvem.
O termo “proxy” cobre funções distintas. Um forward proxy representa o cliente diante de servidores externos. Um reverse proxy representa servidores internos diante dos clientes. Um gateway pode traduzir ou intermediar protocolos, e um túnel apenas retransmite os dados após o estabelecimento da conexão. A RFC 9110 diferencia esses papéis porque a posição do intermediário muda completamente o objetivo técnico, os riscos e a forma de projetar o serviço.
Também é importante separar proxy de firewall, NAT, VPN e load balancer. Um mesmo appliance pode reunir essas funções, mas elas não são equivalentes. O proxy atua no relacionamento entre clientes e serviços; o firewall aplica política de segurança; o NAT traduz endereços; a VPN cria um canal protegido; e o balanceador distribui tráfego entre destinos. O projeto precisa entender a função arquitetural, não apenas o nome comercial do equipamento.
Como funciona um servidor proxy
Quando um cliente utiliza um proxy, a sessão é intermediada. O cliente envia sua requisição ao proxy, o proxy avalia política e contexto e, se permitido, cria ou reutiliza uma conexão até o destino. A resposta retorna pelo mesmo intermediário.
Em um forward proxy explícito, o navegador ou sistema conhece o endereço do proxy. Em outros modelos, o tráfego pode ser encaminhado por mecanismos de rede, agentes ou políticas de endpoint. Já o reverse proxy recebe requisições como se fosse o servidor de origem, mas encaminha internamente para um ou mais backends.
Forward proxy
O forward proxy fica do lado do cliente. Ele pode controlar acesso à Internet, aplicar autenticação, registrar destinos, filtrar categorias, impor políticas de uso e otimizar determinados conteúdos.
Em empresas, ele costuma ser integrado a identidade, políticas de navegação e mecanismos de segurança. O ponto de atenção é que o proxy se torna uma dependência do acesso: se estiver indisponível e não houver contingência, aplicações externas podem deixar de funcionar.
Reverse proxy
O reverse proxy fica diante de aplicações ou servidores. Ele recebe conexões dos clientes e encaminha para backends.
A RFC 9110 descreve o gateway — também chamado de reverse proxy — como um intermediário que se apresenta como servidor de origem na conexão externa e encaminha as requisições para servidores internos. Essa função é amplamente usada para encapsular serviços, melhorar desempenho, distribuir carga e proteger a exposição direta dos backends.
Proxy explícito e transparente
Em proxy explícito, a estação sabe que existe um intermediário e envia tráfego a ele de forma intencional.
Em proxy transparente, a aplicação pode não estar configurada para usar proxy; a rede redireciona ou intercepta o fluxo conforme arquitetura.
Transparência pode simplificar implantação, mas também aumenta a importância de compatibilidade, tratamento de HTTPS, diagnóstico e documentação.
Proxy, gateway, túnel e reverse proxy
Os termos são frequentemente usados de forma imprecisa.
Um proxy participa da comunicação e pode interpretar a mensagem.
Um gateway faz intermediação entre uma conexão de entrada e outra de saída, podendo inclusive falar protocolos diferentes.
Um túnel retransmite os dados depois de estabelecido. Ele não precisa compreender a semântica da aplicação.
Um reverse proxy é uma forma de gateway posicionado diante de servidores.
Essa diferenciação importa porque inspeção, cache, autenticação e observabilidade dependem de o intermediário efetivamente compreender o protocolo.
Proxy x firewall x NAT x VPN
Essas funções podem coexistir, mas resolvem problemas diferentes.
| Função | Objetivo principal | Camada típica |
| Proxy | intermediar cliente e serviço | aplicação |
| Firewall | controlar tráfego por política | rede a aplicação |
| NAT | traduzir endereços/portas | rede/transporte |
| VPN | proteger comunicação entre pontos | rede/transporte |
| Load balancer | distribuir conexões | transporte/aplicação |
Um NGFW pode incluir proxy, inspeção TLS, VPN e NAT no mesmo equipamento. Ainda assim, o projeto deve especificar cada requisito separadamente.
O artigo NGFW: o que é um Next Generation Firewall e quando usar aprofunda o papel do firewall de nova geração.
Proxy HTTP e HTTPS
HTTP foi projetado para operar com intermediários. Cabeçalhos e semântica do protocolo permitem que proxies participem de cache, autenticação, redirecionamento e encaminhamento.
Em HTTPS, a situação depende da arquitetura. Se o proxy apenas estabelece um túnel para o destino, o conteúdo permanece protegido ponta a ponta entre cliente e servidor. Se houver terminação TLS no proxy, ele passa a descriptografar e recriptografar o tráfego, o que altera requisitos de confiança, certificados, privacidade e governança.
CONNECT
O método CONNECT é usado para solicitar que um proxy estabeleça um túnel até um destino.
É comum em navegação HTTPS por forward proxy. Depois do túnel, o proxy pode atuar apenas como relay, dependendo da política implementada.
Inspeção TLS
Em ambientes corporativos, algumas arquiteturas realizam inspeção TLS.
Nesse caso, o proxy termina a sessão do cliente e cria outra sessão até o servidor externo. Para evitar alertas, o endpoint precisa confiar na autoridade certificadora usada pela organização.
Essa arquitetura exige governança rigorosa. Aplicações com certificate pinning, mutual TLS ou requisitos específicos podem falhar quando o tráfego é intermediado.
Autenticação e identidade
Proxies corporativos podem autenticar usuários e dispositivos antes de liberar acesso.
A identidade permite políticas mais específicas do que filtragem por IP. Um usuário pode ter acesso a determinadas categorias ou serviços independentemente da estação utilizada.
Integração com diretórios, SSO e agentes precisa ser desenhada para evitar loops de autenticação e perda de contexto.
Logs também devem registrar identidade de forma consistente para permitir auditoria.
Política de acesso e filtragem
Forward proxies podem controlar acesso por domínio, categoria, horário, usuário, grupo, aplicação ou risco.
A política precisa ser proporcional. Bloquear por categoria não substitui análise de ameaça, e permitir um domínio não significa que todo conteúdo nele seja seguro.
Em ambientes críticos, a política deve diferenciar navegação de usuário, atualizações de sistema, APIs, integrações e tráfego de servidores.
Cache
Proxies podem armazenar respostas para reduzir latência e consumo de banda.
Cache é útil quando o conteúdo é reutilizável e as regras HTTP permitem armazenamento.
Conteúdo personalizado, sensível ou dinâmico exige cuidado.
Uma política incorreta pode servir informação desatualizada ou expor dados entre usuários.
O Protocolo HTTP aprofunda semântica, cabeçalhos e cache.
Reverse proxy e publicação de aplicações
Reverse proxies são comuns na publicação de aplicações Web.
Eles podem:
- terminar TLS;
- esconder backends;
- distribuir requisições;
- aplicar limites;
- fazer health checks;
- inserir ou remover cabeçalhos;
- centralizar certificados;
- integrar WAF;
- aplicar autenticação.
A vantagem arquitetural é desacoplar o endpoint público dos servidores internos.
Load balancing
Um reverse proxy pode distribuir tráfego entre múltiplos backends.
A seleção pode usar round-robin, least connections, hash ou critérios mais sofisticados.
O algoritmo precisa ser compatível com o estado da aplicação.
Aplicações que mantêm sessão local podem exigir afinidade ou arquitetura de estado compartilhado.
Health checks
Health checks determinam se um backend deve receber tráfego.
Um teste simples de porta aberta pode indicar que o processo está vivo, mas não que a aplicação está funcional.
Para serviços críticos, o health check deve validar uma condição representativa sem gerar carga excessiva.
Headers e preservação de contexto
Quando existe proxy, o backend pode enxergar o IP do intermediário em vez do IP original.
Cabeçalhos como Forwarded e X-Forwarded-For são usados para transportar contexto.
Esses cabeçalhos precisam ser tratados com confiança explícita. Um servidor não deve aceitar indiscriminadamente valores enviados diretamente por clientes.
Proxy e DMZ
Reverse proxies costumam ser posicionados em DMZs para evitar exposição direta dos servidores internos.
A DMZ entre redes TI e OT ilustra o princípio de criar zonas intermediárias e controlar fluxos entre domínios de confiança diferentes.
Em uma DMZ, o proxy pode funcionar como ponto controlado de publicação.
A arquitetura deve restringir quais conexões o proxy pode iniciar para o ambiente interno.
Proxy em ambientes OT
Em redes industriais e OT, acesso direto à Internet costuma ser limitado.
Um proxy pode servir como ponto controlado para atualizações, repositórios e integrações específicas.
Porém, inserir proxy em protocolos que não foram projetados para HTTP exige cautela.
A função deve estar alinhada à segmentação e aos requisitos de disponibilidade do processo industrial.
Proxy em nuvem e SSE/SASE
Serviços de segurança em nuvem podem oferecer funções de proxy, secure web gateway e controle de aplicações.
Nesse modelo, o tráfego é encaminhado para pontos de presença do provedor.
A organização troca parte da infraestrutura local por dependência de conectividade e do serviço contratado.
Projeto de arquitetura precisa considerar latência, contingência, identidade e caminhos de tráfego.
PAC e WPAD
Arquivos PAC permitem selecionar dinamicamente qual proxy utilizar conforme URL, domínio ou rede.
WPAD pode automatizar descoberta em determinados ambientes.
Esses mecanismos reduzem configuração manual, mas também adicionam dependências.
Alterações no PAC podem afetar milhares de dispositivos rapidamente.
Proxy e DNS
A resolução DNS pode ocorrer no cliente ou no proxy, conforme protocolo e configuração.
Essa diferença influencia logs, split DNS e troubleshooting.
Em alguns cenários, o cliente envia o hostname ao proxy e o proxy resolve o destino. Em outros, o cliente já entrega um endereço resolvido.
O artigo DNS: como funciona, registros, cache e DNSSEC ajuda a entender essa dependência.
Privacidade e logging
Proxies podem registrar grande volume de informação sobre navegação e aplicações.
A retenção precisa ter finalidade, controle de acesso e prazo coerentes com a política da organização e a legislação aplicável.
Logs são importantes para troubleshooting e segurança, mas também são dados sensíveis.
Arquitetura de observabilidade deve considerar quem pode consultar, exportar e correlacionar essas informações.
Monitoramento de proxy
Disponibilidade do processo não é suficiente.
Indicadores úteis incluem:
- conexões simultâneas;
- requisições por segundo;
- latência;
- erros upstream;
- uso de CPU e memória;
- cache hit ratio;
- falhas de autenticação;
- erros TLS;
- filas;
- consumo de banda.
O artigo Monitoramento de Rede complementa essa abordagem.
Dimensionamento de capacidade
Proxy deve ser dimensionado por perfil de tráfego, não apenas pela velocidade da interface.
Inspeção TLS consome CPU.
Muitos objetos pequenos podem gerar grande quantidade de conexões.
Downloads grandes consomem banda e memória.
Autenticação e logging também produzem carga.
O dimensionamento precisa representar o cenário real.
Alta disponibilidade
Dois proxies não garantem disponibilidade se os clientes não conseguem selecionar o segundo.
O desenho deve definir:
- mecanismo de failover;
- distribuição de configuração;
- sincronização de política;
- dependência de DNS;
- dependência de load balancer;
- comportamento do PAC;
- persistência de sessão.
Também é necessário testar o failover.
Arquitetura de referência
Uma arquitetura corporativa pode separar três funções:
- proxy de saída para navegação e APIs externas;
- reverse proxy de entrada para aplicações publicadas;
- proxies internos para zonas ou integrações específicas.
A separação reduz mistura de políticas e facilita troubleshooting.
O desenho final deve refletir risco e escala.
Critérios de engenharia para selecionar uma solução proxy
A seleção deve começar pela função.
Perguntas relevantes:
- é forward ou reverse proxy?
- haverá inspeção TLS?
- quantos usuários ou serviços?
- qual tráfego de pico?
- existe autenticação?
- quais protocolos?
- quais requisitos de logging?
- qual HA?
- qual integração com cloud?
- quais aplicações não toleram proxy?
A resposta gera requisitos mensuráveis.
Levantamento da infraestrutura existente
Antes de migrar um proxy legado, é necessário recuperar PACs, exceções, fluxos, certificados e aplicações dependentes. Sem baseline, a troca de plataforma pode romper serviços que nunca foram formalmente documentados.
Em ambientes brownfield, é comum encontrar proxies antigos, PACs não documentados, exceções de aplicações e certificados distribuídos manualmente.
Antes de migrar, é necessário descobrir dependências.
Um Levantamento Cadastral de Engenharia pode recuperar topologia, fluxos e ativos envolvidos.
Design Review da arquitetura
Forward proxy, reverse proxy, inspeção TLS, autenticação, HA e DNS formam uma arquitetura integrada. Uma revisão independente identifica incompatibilidades antes da implantação.
A revisão deve avaliar:
- função de cada proxy;
- fluxo de entrada e saída;
- TLS;
- autenticação;
- HA;
- logging;
- DNS;
- integrações;
- exceções;
- capacidade.
A Revisão e Validação Técnica de Projetos — Design Review permite verificar coerência antes da implantação.
Migração de proxy
Migrações precisam preservar acesso de usuários e integrações.
É recomendável mapear aplicações críticas, criar grupos piloto, validar autenticação, revisar certificados e preparar rollback.
Aplicações legadas podem depender de comportamento específico do proxy antigo.
Por isso, a migração deve ser tratada como mudança de arquitetura, não apenas troca de appliance.
Comissionamento e aceite
O aceite deve testar condições normais e de falha.
Para forward proxy:
- autenticação;
- políticas;
- bypass;
- HTTPS;
- logs;
- failover.
Para reverse proxy:
- TLS;
- health checks;
- balanceamento;
- headers;
- perda de backend;
- disponibilidade.
O Comissionamento de Equipamentos pode estruturar a matriz de testes e evidências.
Troubleshooting de proxy
Uma sequência útil é identificar:
- o cliente usa proxy?
- qual configuração foi aplicada?
- o proxy resolve o destino?
- a autenticação funciona?
- há regra bloqueando?
- existe falha TLS?
- o upstream responde?
- o backend está saudável?
- o log confirma a causa?
Essa sequência evita atribuir qualquer falha de aplicação à “Internet”.
Erros recorrentes
| Erro | Consequência |
| proxy único | ponto único de falha |
| PAC sem governança | impacto massivo |
| inspeção TLS sem inventário | aplicações quebradas |
| logs sem retenção definida | risco de privacidade |
| health check superficial | backend inválido em produção |
| X-Forwarded-For sem confiança | spoofing de contexto |
| exceções permanentes | perda de controle |
| ausência de baseline | troubleshooting lento |
Como contratar projeto ou revisão de proxy
O escopo precisa definir mais que “configurar proxy”.
Deve estabelecer objeto, fluxos, políticas, interfaces, autenticação, certificados, disponibilidade, migração, testes e documentação.
Entregáveis podem incluir:
- levantamento;
- arquitetura;
- matriz de fluxos;
- requisitos;
- política de acesso;
- desenho de HA;
- plano de migração;
- matriz de testes;
- documentação As-Built.
Critérios de aceite precisam ser objetivos.
Baseline e ciclo de vida
Após implantação, configuração, certificados, políticas, integrações e exceções devem formar uma baseline.
Alterações precisam ser controladas.
Certificados expiram.
Versões ficam obsoletas.
Políticas acumulam exceções.
Revisões periódicas evitam que o proxy se torne um ponto opaco da infraestrutura.
Governança de exceções e bypass
Em proxies corporativos, exceções são inevitáveis: aplicações legadas, integrações com certificado próprio, APIs sensíveis a inspeção TLS e serviços que não suportam autenticação podem exigir bypass. O problema surge quando a exceção vira regra permanente e deixa de ter responsável, justificativa e prazo.
Uma governança adequada registra origem da solicitação, serviço afetado, risco aceito, duração, condição de revisão e evidência técnica que justificou o desvio. Isso evita que listas de bypass cresçam indefinidamente e criem caminhos fora do controle arquitetural.
Exceções também devem ser verificadas após atualizações. Uma incompatibilidade que exigiu bypass em determinada versão pode deixar de existir depois de correção do software. Sem revisão periódica, a organização mantém exposição desnecessária.
Inspeção TLS: requisitos técnicos e limites
Quando o proxy realiza terminação TLS, ele passa a ocupar posição de alta confiança. A arquitetura precisa controlar a autoridade certificadora utilizada, a distribuição da confiança aos endpoints, o armazenamento das chaves e a definição de quais categorias ou aplicações não serão inspecionadas.
Essa função também afeta desempenho. Cada sessão exige operações criptográficas e mantém estado adicional. O dimensionamento precisa considerar taxa de novas conexões, sessões simultâneas, versões de TLS, tamanho de chave, suites utilizadas e perfil real de tráfego. Um throughput divulgado sem inspeção ativa não representa necessariamente a capacidade em produção.
Aplicações com mutual TLS, certificate pinning ou mecanismos próprios de confiança podem recusar a intermediação. O inventário dessas aplicações deve anteceder a mudança. A engenharia precisa decidir entre compatibilizar, criar exceção justificada ou manter caminho específico.
Arquitetura de egress e controle de saída
Em redes corporativas, o proxy de saída pode ser parte de uma arquitetura de egress controlado. Em vez de permitir que qualquer servidor ou estação alcance diretamente a Internet, os fluxos passam por pontos específicos, com política, autenticação e logging centralizados.
Esse desenho reduz superfícies de saída, mas cria dependência clara. Aplicações de servidor, atualizações de software e integrações de API precisam ser mapeadas para que o bloqueio do acesso direto não interrompa serviços. O projeto deve identificar quais fluxos realmente exigem Internet e por quais meios.
O egress também precisa ser compatível com DNS, firewall e roteamento. Permitir HTTP no proxy enquanto a rede continua oferecendo saída direta por outros caminhos gera política inconsistente. Os controles devem formar um conjunto coerente.
Capacidade, latência e engenharia de desempenho
O desempenho de um proxy deve ser analisado por mais de uma métrica. Throughput mede volume agregado, mas quantidade de conexões, taxa de novas sessões, tempo de resposta, consumo de CPU e memória podem atingir limites antes da banda nominal.
Em forward proxy, picos de início de expediente podem produzir grande quantidade de conexões simultâneas. Em reverse proxy, campanhas, integrações e APIs podem gerar bursts. A arquitetura deve considerar pico e não apenas média diária.
Também é necessário medir a contribuição do próprio proxy para a latência. Autenticação, inspeção, consulta de reputação, WAF, cache e logging adicionam processamento. O objetivo não é eliminar toda latência, mas garantir que ela permaneça dentro do requisito e seja observável.
| Métrica | Por que importa | Evidência |
| Throughput | volume agregado | teste de carga |
| Novas conexões/s | picos e APIs | telemetria |
| Sessões simultâneas | estado mantido | métrica operacional |
| Latência adicionada | experiência da aplicação | medição ponta a ponta |
| CPU/memória | capacidade residual | baseline e pico |
Logs como evidência operacional e contratual
Logs de proxy são úteis para investigação, troubleshooting, auditoria e medição de serviço. Porém, seu valor depende de integridade, sincronização de tempo e contexto suficiente. Um registro sem identidade, destino, ação e timestamp pode ser insuficiente para explicar o evento.
Em ambientes críticos, é recomendável definir quais eventos devem ser enviados a plataforma central, por quanto tempo serão retidos e quais campos são necessários. Isso precisa ser compatível com volume e custo de armazenamento.
Quando o serviço é terceirizado, a disponibilidade de logs deve constar do escopo. O contratante precisa saber se terá acesso bruto, consulta limitada ou somente relatórios do fornecedor. Essa diferença afeta capacidade de fiscalização e resposta a incidentes.
Requisitos para contratação e procurement técnico
A especificação deve separar requisito funcional de produto. Em vez de exigir simplesmente determinada marca, o documento pode definir capacidade mínima, protocolos, integração de identidade, HA, mecanismos de TLS, formatos de log, APIs, suporte e critérios de teste.
Também é importante exigir comprovação das condições de desempenho. Um fornecedor pode declarar throughput elevado, mas a proposta precisa indicar se esse valor se mantém com inspeção TLS, logging e políticas habilitadas. A comparação deve usar cenários equivalentes.
Licenças e subscrições entram na análise de ciclo de vida. Recursos importantes podem depender de serviços externos de reputação ou assinatura anual. O custo de renovação deve ser conhecido antes da aquisição para evitar perda de funcionalidade depois do primeiro período.
Operação assistida e estabilização pós-migração
Depois do corte, é recomendável um período de operação assistida. Nessa fase, a equipe acompanha erros, aplicações incompatíveis, latência, falhas de autenticação e comportamento das exceções com maior frequência.
O objetivo é distinguir defeito de implantação de ajuste normal de estabilização. Alterações realizadas durante esse período precisam ser registradas para que o As-Built reflita o estado realmente entregue.
Ao final, a transição para operação deve incluir baseline, procedimentos, contatos de suporte, inventário de certificados, política de mudança e documentação de contingência. Sem handover, conhecimento permanece concentrado na equipe de implantação.
Matriz de requisitos e critérios de aceite
Antes da implantação, os requisitos do proxy devem ser convertidos em uma matriz rastreável. Cada requisito precisa indicar origem, prioridade, método de verificação e evidência esperada. Isso evita que a discussão de aceite dependa de interpretação posterior.
Para um forward proxy, por exemplo, um requisito de autenticação pode ser verificado por teste com usuários autorizados e não autorizados. Um requisito de alta disponibilidade pode ser validado por falha controlada de um nó. Um requisito de logging precisa indicar quais campos devem aparecer e em quanto tempo ficam disponíveis para consulta.
Essa rastreabilidade também ajuda a separar requisito funcional de preferência de produto. Se a solução cumpre o comportamento exigido e produz a evidência prevista, a fiscalização possui base objetiva para o aceite.
Recebimento técnico e transferência para operação
O recebimento técnico deve consolidar configuração, licenças, certificados, inventário, documentação, backups e resultados de testes. Pendências precisam estar classificadas e possuir responsável e prazo.
Também é necessário confirmar que a equipe de operação possui acesso administrativo, procedimentos de recuperação e contatos de suporte. Um proxy tecnicamente funcional, mas dependente de credenciais ou conhecimento exclusivo do integrador, ainda não está plenamente transferido.
O encerramento deve registrar a baseline aprovada. Essa baseline passa a ser a referência para futuras mudanças, auditorias e troubleshooting, reduzindo o risco de alterações não rastreadas.
Cenários de falha que devem ser simulados
Um proxy crítico precisa ser validado em condições degradadas, porque muitos defeitos só aparecem quando algum componente deixa de responder. A matriz de testes deve incluir perda de um nó do cluster, indisponibilidade de DNS, falha do serviço de identidade, backend fora do ar, expiração ou substituição de certificado e perda de conectividade com serviços externos utilizados pelo proxy.
Para cada cenário, deve existir um comportamento esperado. Se o serviço de identidade falhar, por exemplo, a política pode bloquear novos acessos, permitir apenas usuários já autenticados ou utilizar um mecanismo de contingência. O importante é que essa decisão seja de projeto, e não uma surpresa durante um incidente.
Também é necessário observar a recuperação. Um cluster pode sobreviver à falha, mas manter sessões presas ao nó indisponível, perder sincronização de configuração ou demorar excessivamente para restabelecer capacidade. O teste precisa registrar tempos, perda percebida e estado final.
Essas simulações transformam alta disponibilidade de uma declaração comercial em evidência técnica. Elas também ajudam a construir procedimentos operacionais, porque a equipe aprende quais sinais aparecem em logs e dashboards durante cada tipo de falha.
Evidências mínimas para auditoria futura
Ao encerrar o projeto, a organização deve preservar evidências suficientes para reconstruir decisões e verificar conformidade no futuro. Isso inclui matriz de requisitos, resultados de testes, export da configuração aprovada, inventário de certificados, política de exceções, diagramas, licenças, versões e registros de aceite.
Esses documentos reduzem dependência do integrador e permitem comparar o estado futuro com a baseline. Em auditorias, incidentes ou expansões, a equipe consegue identificar se uma alteração foi planejada, se determinado bypass tinha justificativa e qual capacidade foi efetivamente validada na entrega.
Como regra de fechamento, a operação deve conseguir responder rapidamente qual política foi aplicada, qual exceção existe, qual certificado está em uso e qual caminho de contingência deve ser acionado. Essa capacidade operacional é parte do resultado do projeto, porque reduz tempo de diagnóstico e dependência de conhecimento informal.
Considerações finais
Servidores proxy são componentes de intermediação que podem melhorar controle, segurança, disponibilidade e desempenho, mas também criam dependências.
O valor do proxy está na arquitetura: função bem definida, política consistente, capacidade adequada, alta disponibilidade, observabilidade e documentação.
Em ambientes críticos, o proxy deve ser projetado e aceito como serviço de infraestrutura, com requisitos e evidências verificáveis.
O aceite precisa provar comportamento sob falha e não apenas acesso em condição normal. Políticas, TLS, backends, logs e failover devem produzir evidências verificáveis.
Referências técnicas
[1] IETF. RFC 9110 — HTTP Semantics. Disponível em: https://www.rfc-editor.org/rfc/rfc9110.
[2] IETF. RFC 7231 — HTTP/1.1 Semantics and Content. Disponível em: https://www.rfc-editor.org/rfc/rfc7231.
[3] IETF. RFC 7234 — HTTP/1.1 Caching. Disponível em: https://www.rfc-editor.org/rfc/rfc7234.
Perguntas frequentes
O forward proxy representa o cliente diante de serviços externos; o reverse proxy representa servidores internos diante dos clientes.
Não. Proxy intermedeia aplicações e serviços; firewall aplica política de tráfego. Um mesmo produto pode implementar as duas funções.
Somente quando a arquitetura termina TLS no proxy e estabelece uma nova sessão até o destino. Isso exige certificados, confiança e governança adequados.
Alguns reverse proxies também balanceiam carga, mas balanceamento é uma função específica e deve ser dimensionada e testada separadamente.
Pelo perfil real de conexões, requisições, banda, inspeção TLS, autenticação, cache, logging e requisitos de alta disponibilidade.
Políticas, autenticação, TLS, disponibilidade, health checks, balanceamento, logs, failover e comportamento de aplicações críticas.