Entenda hypervisor, máquinas virtuais, tipo 1 e 2, CPU, memória, storage, rede virtual, HA, backup, segurança, capacidade e critérios de projeto.
Confira!
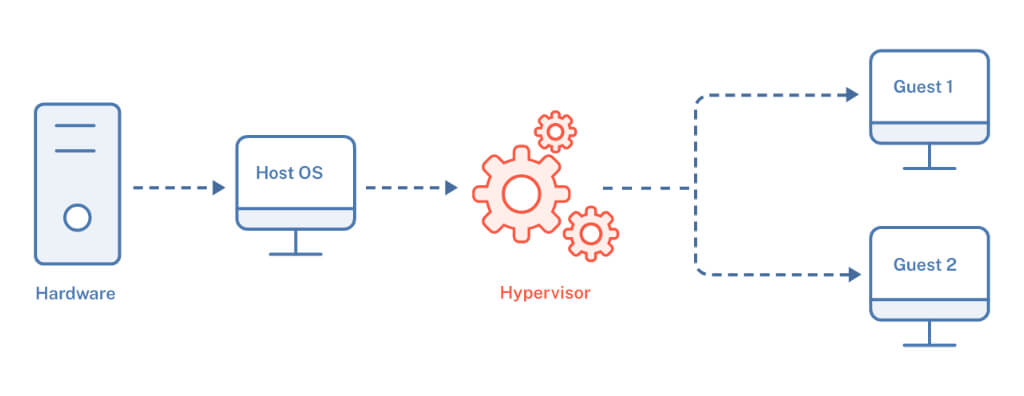
Um hypervisor é a camada de virtualização que administra máquinas virtuais e controla o acesso de sistemas operacionais convidados aos recursos físicos do host. O NIST define hypervisor, também chamado de Virtual Machine Monitor (VMM), como o componente que gerencia os guest OSs e controla o fluxo de instruções entre esses sistemas e o hardware físico.
Na prática, o hypervisor permite que um único servidor físico execute várias máquinas virtuais independentes, cada uma com CPU virtual, memória, interfaces de rede, discos e sistema operacional próprios. Essa abstração melhora consolidação, isolamento, mobilidade, recuperação e gestão de capacidade, mas também concentra dependências: falhas no host, storage, rede ou na própria plataforma de virtualização podem afetar várias cargas simultaneamente.
Em ambientes corporativos e de missão crítica, virtualização não deve ser tratada apenas como instalação de software. Ela envolve arquitetura de compute, memória, storage, rede, alta disponibilidade, backup, segurança, licenciamento, observabilidade, capacidade e ciclo de vida. O hypervisor é apenas uma das camadas dessa infraestrutura.
O que é um hypervisor
O hypervisor cria e administra ambientes virtuais sobre recursos físicos.
Ele apresenta às máquinas virtuais uma visão controlada de:
- processadores;
- memória;
- interfaces de rede;
- discos;
- dispositivos;
- timers;
- interrupções.
Cada VM opera como se possuísse hardware próprio, embora os recursos sejam compartilhados.
Máquina virtual
Uma VM é um conjunto isolado de recursos virtuais no qual um sistema operacional e suas aplicações são executados.
Ela pode ser iniciada, parada, clonada, migrada e protegida de forma independente.
Host
O host é o servidor físico que executa o hypervisor.
A capacidade do host determina o limite agregado de processamento, memória, I/O e conectividade disponível às VMs.
Hypervisor tipo 1 e tipo 2
A classificação mais conhecida separa hypervisors em tipo 1 e tipo 2.
Tipo 1
O hypervisor tipo 1 executa diretamente sobre o hardware ou sobre uma camada mínima especializada.
É comum em data centers e produção.
Vantagens:
- menor dependência de um sistema operacional hospedeiro;
- melhor controle de recursos;
- maior previsibilidade;
- integração com clustering e HA.
Tipo 2
O hypervisor tipo 2 executa como aplicação sobre um sistema operacional hospedeiro.
É comum em desktops, laboratórios e desenvolvimento.
Nesse caso, a VM depende também do host OS.
Virtualização completa
Na full virtualization, o hypervisor apresenta hardware virtual compatível com a arquitetura física, permitindo executar sistemas operacionais convidados sem modificação específica.
Essa abordagem simplifica compatibilidade.
O NIST define full virtualization como execução de sistemas operacionais e aplicações sobre hardware virtualizado.
Paravirtualização
Na paravirtualização, o guest utiliza interfaces específicas oferecidas pelo hypervisor.
Isso pode reduzir overhead em determinadas operações.
Drivers paravirtualizados são comuns para rede e storage mesmo em plataformas de virtualização completa.
Hardware-assisted virtualization
Processadores modernos incluem extensões para virtualização.
Essas extensões ajudam o hypervisor a executar instruções sensíveis com menor overhead e melhor isolamento.
A presença de suporte de CPU é um requisito importante em servidores de virtualização.
Virtual CPU
Uma vCPU representa capacidade de processamento apresentada à VM.
Ela não deve ser interpretada automaticamente como um núcleo físico exclusivo.
O hypervisor agenda vCPUs sobre CPUs físicas.
Oversubscription
É possível alocar mais vCPUs do que núcleos físicos.
Isso funciona quando as VMs não demandam pico simultaneamente.
Oversubscription excessivo aumenta espera de CPU e latência.
CPU ready
Métricas de espera mostram quanto tempo uma VM permanece pronta para executar aguardando recurso físico.
Valores elevados indicam contenção.
Dimensionamento precisa observar comportamento real.
Memória
A memória virtual também é gerenciada pelo hypervisor.
Cada VM recebe um limite.
Se a soma das alocações excede a capacidade física, a plataforma pode utilizar mecanismos de otimização.
Overcommit
Memory overcommit permite comprometer mais memória virtual que a física.
O risco aparece quando muitas VMs demandam o máximo simultaneamente.
Ballooning
Algumas plataformas utilizam balloon drivers para recuperar memória de VMs.
Isso precisa ser compreendido antes de interpretar métricas.
Swapping
Quando memória física é insuficiente, o hypervisor pode recorrer a swapping.
Isso pode degradar fortemente desempenho.
Em cargas críticas, swapping sustentado é um sinal de dimensionamento inadequado.
Storage virtual
Discos virtuais são apresentados às VMs a partir de storage local ou compartilhado.
A performance depende de:
- latência;
- IOPS;
- throughput;
- fila;
- cache;
- redundância.
CPU e RAM adequadas não compensam storage saturado.
Datastore
Datastore é uma unidade lógica de armazenamento utilizada pela plataforma.
Pode residir em SAN, NAS, storage distribuído ou disco local.
Thin provisioning
Thin provisioning aloca capacidade sob demanda.
Ele melhora utilização, mas exige monitoramento rigoroso.
Se muitos discos virtuais crescem simultaneamente, o datastore pode esgotar.
Thick provisioning
Thick provision reserva capacidade previamente.
Oferece previsibilidade maior de espaço.
A escolha deve considerar desempenho e governança.
Rede virtual
O hypervisor cria switches virtuais e interfaces virtuais.
Uma VM pode comunicar-se com outras VMs no mesmo host, com outros hosts ou com a rede física.
vSwitch
O virtual switch executa comutação entre interfaces virtuais.
Ele pode suportar VLANs, políticas, teaming e controles adicionais.
Port groups
Grupos de portas associam configurações de rede a conjuntos de VMs.
Eles ajudam a padronizar VLAN, políticas e segurança.
Uplinks físicos
O tráfego virtual chega à rede física por interfaces do host.
Redundância precisa considerar múltiplos uplinks e switches físicos.
VLANs
Virtualização costuma depender intensamente de VLANs.
Redes podem ser separadas por função:
- gestão;
- storage;
- migração;
- produção;
- backup;
- cluster.
Misturar tudo em uma única rede aumenta risco e contenção.
Rede de gestão
A interface administrativa do hypervisor é crítica.
Ela deve possuir acesso restrito.
Controles podem incluir:
- segmentação;
- firewall;
- MFA;
- bastion;
- logging;
- monitoramento.
Comprometer o hypervisor pode comprometer todas as VMs do host.
Storage network
Protocolos como iSCSI, NFS e Fibre Channel conectam hosts ao armazenamento.
Cada tecnologia possui requisitos próprios.
Latência e redundância são fundamentais.
Live migration
Plataformas empresariais permitem migrar VMs entre hosts com mínima interrupção.
Isso facilita manutenção e balanceamento.
A migração depende de compatibilidade, rede e storage.
Requisitos
É necessário verificar:
- compatibilidade de CPU;
- conectividade;
- latência;
- capacidade;
- versão da plataforma.
Migração não deve ser presumida.
High Availability
Clusters podem reiniciar VMs em outro host após falha física.
Isso reduz indisponibilidade.
HA não significa operação sem interrupção.
A VM pode precisar reiniciar.
Fault Tolerance
Algumas plataformas oferecem mecanismos mais avançados de tolerância a falha.
Eles replicam estado entre hosts.
O custo de recursos é maior.
O requisito deve justificar a complexidade.
Cluster
Um cluster agrupa hosts gerenciados de forma coordenada.
Ele permite:
- HA;
- balanceamento;
- migração;
- manutenção;
- expansão.
O cluster precisa ter capacidade residual para sobreviver à falha de um ou mais hosts.
N+1 e capacidade de falha
Se todos os hosts operam próximos de 100%, não existe espaço para absorver falha.
N+1 significa manter capacidade suficiente para a perda de um componente.
Ambientes mais críticos podem exigir N+2.
A reserva precisa ser calculada sobre carga de pico.
DRS e balanceamento
Plataformas podem mover VMs para equilibrar recursos.
A automação precisa respeitar afinidade, licenciamento e requisitos de aplicação.
Nem toda VM pode ser movida livremente.
Affinity e anti-affinity
Regras de afinidade mantêm VMs juntas.
Anti-affinity separa VMs redundantes entre hosts.
Exemplo: dois controladores de domínio não deveriam depender do mesmo host se existe capacidade de separação.
Backup de máquinas virtuais
Snapshot não é backup.
Backup precisa preservar dados e permitir restauração independente da plataforma original.
Snapshot
Snapshot registra estado em determinado ponto.
É útil para mudanças temporárias.
Manter snapshots por longos períodos pode degradar desempenho e consumir storage.
Backup consistente
Aplicações com bancos precisam de mecanismos de consistência.
Copiar um disco em uso pode não garantir recuperação correta.
Disaster recovery
Virtualização facilita replicação de VMs para site alternativo.
O projeto precisa definir:
- RPO;
- RTO;
- largura de banda;
- prioridade de workloads;
- ordem de inicialização;
- dependências.
O DR precisa ser testado.
Segurança do hypervisor
O NIST destaca que o hypervisor medeia acesso aos recursos físicos e fornece isolamento entre VMs.
Essa função torna a plataforma um componente de alta confiança.
Controles essenciais incluem:
- patching;
- hardening;
- controle administrativo;
- logs;
- segregação;
- backup da configuração.
VM escape
Uma vulnerabilidade de isolamento pode permitir que código em uma VM afete o hypervisor ou outra VM.
Esses cenários são raros, mas de alto impacto.
Manter a plataforma atualizada é essencial.
Secure Boot e TPM
Recursos de hardware podem apoiar integridade da inicialização.
TPM também pode participar de atestação e proteção de chaves.
O suporte depende da plataforma.
Gestão de patches
Atualizar hypervisors exige coordenação.
Em clusters, migração permite esvaziar um host, atualizar e devolver ao serviço.
Esse processo precisa ser planejado.
Falhas durante atualização podem afetar todo o cluster.
Compatibilidade de hardware
Fabricantes publicam listas de hardware compatível.
NICs, HBAs, CPUs e storage precisam ser suportados.
Usar hardware fora da matriz pode dificultar suporte.
Firmware
BIOS, NIC, controladoras e storage também exigem firmware.
O ciclo de atualização precisa coordenar hypervisor e hardware.
Monitoramento
Indicadores fundamentais:
- CPU;
- CPU ready;
- memória;
- swapping;
- latência de storage;
- IOPS;
- filas;
- throughput;
- perda de rede;
- uso de datastore;
- estado do cluster.
Monitoramento deve detectar tendência, não apenas falha.
Capacity planning
Capacidade precisa considerar crescimento.
Novas VMs consomem compute, memória e storage.
A soma das solicitações individuais pode ultrapassar reserva de cluster.
Planejamento precisa projetar horizonte.
Workloads críticos
Bancos de dados, VMS, sistemas de controle e aplicações de baixa latência podem exigir tratamento específico.
É necessário validar:
- licenciamento;
- NUMA;
- storage;
- CPU;
- afinidade;
- backup.
Virtualização não elimina requisitos da aplicação.
NUMA
Servidores grandes possuem Non-Uniform Memory Access.
VMs muito grandes podem atravessar nós NUMA e sofrer latência adicional.
O dimensionamento deve evitar VMs superdimensionadas sem necessidade.
GPU virtualization
GPUs podem ser compartilhadas ou dedicadas a VMs.
Casos:
- VDI;
- IA;
- analytics;
- renderização.
Licenciamento e compatibilidade variam.
Virtualização x containers
VMs virtualizam hardware e executam sistemas operacionais separados.
Containers compartilham o kernel do host.
O artigo Docker aprofunda containers.
Os modelos podem coexistir.
Containers frequentemente executam dentro de VMs.
Virtualização e cloud
IaaS utiliza conceitos de virtualização em grande escala.
O usuário provisiona instâncias sem administrar o hardware físico.
O artigo Computação em nuvem na prática detalha essa relação.
Hyperconverged Infrastructure
HCI integra compute, storage e virtualização em nós padronizados.
O storage é distribuído entre hosts.
Essa arquitetura simplifica expansão em blocos.
Em contrapartida, falhas e capacidade precisam ser avaliadas de forma integrada.
Licenciamento
Licenciamento pode depender de:
- host;
- CPU;
- núcleo;
- VM;
- assinatura;
- recursos habilitados.
Mudanças comerciais podem alterar TCO.
A arquitetura precisa ser economicamente sustentável.
Vendor lock-in
Formatos de VM, ferramentas e APIs podem criar dependência.
A mitigação inclui:
- documentação;
- formatos interoperáveis quando possível;
- backup independente;
- automação;
- plano de migração.
Seleção de plataforma
Critérios relevantes:
| Critério | Pergunta |
| desempenho | suporta a carga? |
| HA | qual comportamento na falha? |
| storage | quais tecnologias são suportadas? |
| rede | como integra com infraestrutura existente? |
| backup | existe ecossistema compatível? |
| segurança | como é feito hardening e patching? |
| suporte | qual ciclo de vida? |
| TCO | qual custo completo? |
Levantamento de infraestrutura
Em ambientes existentes, expansão ou migração de virtualização deve começar por inventário de hosts, VMs, storage, redes, versões e dependências.
Projetos brownfield precisam conhecer hosts, VMs, storage, redes e dependências.
Um Levantamento Cadastral de Engenharia pode consolidar a baseline de infraestrutura antes de expansão ou migração.
Design Review da virtualização
CPU, memória, storage, rede, HA e segurança precisam ser avaliados como uma única arquitetura antes da implantação.
Uma arquitetura de virtualização deve ser revisada como sistema.
O Design Review em Projetos de Engenharia pode avaliar capacidade, HA, storage, rede, segurança e integração.
Engenharia de confiabilidade e disponibilidade
Ambientes críticos precisam quantificar impacto de falhas e reservas.
A Engenharia de Confiabilidade e Disponibilidade pode estruturar análise de criticidade, redundância e continuidade.
Comissionamento
A alta disponibilidade só existe de fato quando falhas previstas, migração, backup e recuperação foram testados e produziram evidências.
Antes do aceite, devem ser testados:
- migração;
- perda de host;
- perda de uplink;
- acesso a storage;
- backup;
- restauração;
- performance;
- monitoramento;
- segurança.
O Comissionamento de Equipamentos ajuda a transformar requisitos em evidências.
Migração de plataforma
Trocar hypervisor exige planejamento.
Etapas podem incluir:
- inventário;
- compatibilidade;
- piloto;
- conversão;
- teste;
- corte;
- estabilização;
- retirada do legado.
Rollback precisa ser definido.
Operação assistida
Após migração ou implantação, é recomendável monitorar:
- contenção;
- latência;
- backup;
- alarmes;
- comportamento de HA;
- compatibilidade.
A baseline deve ser atualizada.
Documentação
Entregáveis importantes:
- diagrama físico;
- diagrama lógico;
- inventário;
- matriz de hosts;
- matriz de VMs;
- redes;
- datastores;
- versões;
- licenças;
- políticas de HA;
- procedimentos.
Essa documentação reduz dependência da equipe de implantação.
Erros recorrentes
| Erro | Consequência |
| oversubscription excessivo | contenção |
| storage subdimensionado | alta latência |
| cluster sem reserva | HA inviável |
| snapshot tratado como backup | risco de perda |
| gestão na mesma rede de usuários | exposição |
| hardware não suportado | falhas de suporte |
| patching sem planejamento | indisponibilidade |
| VM superdimensionada | desperdício e pior desempenho |
Arquitetura de cluster e distribuição de workloads
O cluster deve ser dimensionado não apenas pela soma de recursos, mas pela forma como workloads críticos são distribuídos. Duas VMs redundantes instaladas no mesmo host compartilham falha comum; o mesmo vale para nós de banco, VMS, controladores de domínio e serviços de autenticação.
Regras de anti-affinity ajudam a manter cargas redundantes em hosts diferentes. Porém, essas regras consomem flexibilidade de balanceamento e precisam ser compatíveis com a capacidade residual do cluster.
Também é importante evitar concentração involuntária. Após manutenções ou falhas, o cluster pode terminar com muitas VMs críticas no mesmo host. A operação precisa verificar a distribuição após cada evento relevante.
Reserva de capacidade para falhas e manutenção
Capacidade disponível em condição normal não é a mesma coisa que capacidade resiliente. Um cluster com 80% de utilização média pode parecer confortável, mas pode ficar saturado após perder um host.
O projeto deve simular cenários N+1, N+2 ou outros definidos pela criticidade. A reserva deve considerar CPU, memória e I/O simultaneamente. Ter memória sobrando não resolve se storage ou uplinks já estão no limite.
Manutenção planejada também consome reserva. Durante atualização, um host pode ser retirado de serviço por horas. O cluster precisa suportar essa condição sem degradar aplicações além do aceitável.
Latência de storage e impacto nas VMs
Storage é frequentemente o gargalo menos visível. Uma VM pode ter CPU e memória disponíveis e ainda responder lentamente porque suas operações de disco aguardam filas no datastore ou na controladora.
Indicadores como latência de leitura, latência de escrita, IOPS, throughput e queue depth precisam ser acompanhados em conjunto. Picos curtos podem ser aceitáveis; latência sustentada tende a impactar várias VMs simultaneamente.
Aplicações de banco de dados, gravação de vídeo e analytics possuem perfis diferentes de I/O. O dimensionamento deve considerar simultaneidade real, não apenas benchmark isolado do storage.
Rede de virtualização e separação de tráfegos
Hosts podem transportar tráfego de VMs, gestão, storage, migração e backup pelos mesmos adaptadores físicos ou por interfaces separadas. O desenho precisa garantir capacidade e isolamento adequados para cada função.
Em algumas arquiteturas, VLANs e QoS são suficientes. Em outras, funções críticas exigem uplinks dedicados. A decisão deve considerar volume, latência, segurança e comportamento sob falha.
Uma migração ao vivo, por exemplo, pode consumir banda significativa. Se ela disputa o mesmo uplink com tráfego de produção sem política adequada, usuários podem perceber degradação.
Backup, replicação e proteção contra falhas lógicas
HA protege principalmente contra falhas de infraestrutura; não protege contra exclusão acidental, corrupção de aplicação, ransomware ou erro de configuração. Por isso, backup e replicação possuem objetivos distintos.
Backups devem ser isolados da plataforma de produção o suficiente para sobreviver a comprometimento administrativo. Também precisam ser testados por restauração, não apenas por status de job concluído.
A estratégia deve relacionar RPO e RTO a cada workload. Um servidor de arquivos e um sistema transacional crítico podem exigir políticas diferentes.
Segregação administrativa e privilégio mínimo
Administradores do hypervisor possuem poder sobre múltiplos sistemas. Contas privilegiadas precisam ser separadas das contas de uso cotidiano, protegidas por MFA quando suportado e auditadas.
Também é recomendável separar funções: quem administra backup não precisa necessariamente ter privilégios totais no cluster; quem opera VMs pode não precisar alterar rede virtual ou storage.
Essa segregação reduz risco operacional e melhora rastreabilidade de mudanças.
Baseline de configuração e hardening
Depois da implantação, a configuração aprovada deve ser registrada como baseline. Ela inclui versões, redes, datastores, políticas de HA, parâmetros de cluster, acesso administrativo e integrações.
Hardening precisa ser compatível com operação. Desabilitar serviços desnecessários, restringir interfaces de gestão e revisar protocolos antigos são medidas comuns. Porém, cada alteração deve ser testada para não interromper backup, monitoramento ou automação.
A baseline também permite detectar drift: mudanças acumuladas que afastam hosts e clusters do padrão aprovado.
Licenciamento e impacto arquitetural
Licenciamento de hypervisors e softwares associados pode alterar decisões de arquitetura. Funcionalidades de HA, migração, backup ou gestão centralizada podem depender de edições específicas ou assinaturas adicionais.
O projeto deve calcular TCO pelo período de vida esperado, incluindo suporte, renovação e crescimento do número de hosts. Uma arquitetura tecnicamente ótima pode ser economicamente inadequada se o modelo de licenciamento escala de forma desfavorável.
Também é importante prever cenário de mudança de fornecedor ou de política comercial, mantendo documentação e backups que facilitem migração.
Testes de failover e recuperação
Um cluster deve provar seu comportamento em falha. Testes podem incluir desligamento controlado de host, perda de uplink, indisponibilidade de datastore e falha de serviço de gestão, conforme risco e capacidade do ambiente.
O teste precisa medir tempo de detecção, tempo de recuperação, VMs afetadas, perda de sessão e estado final. Também deve registrar se a capacidade residual permaneceu dentro dos limites.
Após o teste, procedimentos operacionais devem ser atualizados com base no comportamento observado.
Critérios de aceite para uma plataforma de virtualização
O aceite deve demonstrar mais do que “VMs ligando”. É necessário comprovar desempenho, acesso a storage, redundância de rede, migração, backup, restauração, monitoramento e comportamento sob falha.
Uma matriz de requisitos pode ligar cada item a procedimento, resultado esperado e evidência. Essa rastreabilidade é especialmente importante quando o ambiente suporta sistemas críticos.
Documentação final deve refletir a configuração realmente entregue e servir como baseline para operação e futuras expansões.
Planejamento de NUMA, sockets e dimensionamento de VMs
VMs muito grandes podem atravessar fronteiras NUMA e aumentar latência de memória. O dimensionamento deve considerar a topologia física do host, quantidade de sockets, núcleos e memória por nó. A regra prática é evitar superdimensionamento sem evidência de necessidade.
Uma VM com muitos vCPUs pode ter desempenho inferior a uma menor se o hypervisor tiver dificuldade para agendar recursos simultâneos. Métricas de aplicação e de hypervisor precisam ser analisadas em conjunto.
Planejamento de manutenção sem indisponibilidade sistêmica
Clusters devem permitir retirar hosts de serviço para atualização de firmware, hypervisor ou hardware. Isso exige capacidade residual e procedimentos de migração. Manutenção não planejada em um cluster sem folga pode degradar todas as VMs restantes.
Janelas devem considerar ordem de atualização, compatibilidade entre versões temporariamente diferentes e possibilidade de retorno. O procedimento precisa ser testado antes de mudanças amplas.
Dependências externas do cluster
Virtualização depende de DNS, NTP, diretório, storage, rede e, em alguns casos, serviços de licenciamento. A perda desses serviços pode não derrubar imediatamente as VMs, mas pode impedir gestão, migração, autenticação ou recuperação.
O projeto deve mapear essas dependências e evitar ciclos. Um erro clássico é hospedar todos os serviços de autenticação e DNS somente dentro do mesmo cluster sem estratégia para administrá-lo durante falha ampla.
Monitoramento da saúde do cluster
Além de CPU e memória, a operação deve acompanhar estado de HA, alarms de hardware, latência de datastores, uso de uplinks, falhas de paths, capacidade livre e eventos de migração. A visão precisa ser agregada e por host.
Tendências ajudam a prever saturação. Crescimento lento de memória, storage ou número de VMs pode consumir a reserva de contingência sem produzir nenhum alarme imediato.
Recuperação da própria camada de virtualização
Planos de backup precisam incluir configuração do ambiente, documentação e informações necessárias para reconstruir a plataforma. Restaurar VMs não resolve se o cluster, redes virtuais e datastores não puderem ser recriados.
Procedimentos de disaster recovery devem considerar ordem de reconstrução: infraestrutura física, gestão, storage, redes e workloads. Essa sequência precisa estar documentada e ser exercitada periodicamente.
Indicadores de aceite e operação
Após implantação, o contratante deve possuir baseline de desempenho e capacidade. Indicadores como CPU ready, latência de storage, memória livre, taxa de backup, tempo de migração e comportamento de failover ajudam a comparar a condição futura com o estado aceito.
Essa baseline é especialmente útil para distinguir crescimento legítimo de degradação e para justificar expansão de hosts, rede ou storage com dados objetivos.
Baseline de desempenho pós-implantação
Após o aceite, a plataforma deve possuir uma baseline de desempenho em condição normal. Ela pode incluir utilização de CPU e memória, CPU ready, latência de storage, IOPS, throughput, uso de uplinks, tempo de migração e duração média de backups.
Essa referência permite identificar degradação futura. Sem baseline, uma equipe pode perceber que “o ambiente está lento”, mas não consegue demonstrar quando o comportamento começou a mudar nem qual recurso perdeu margem.
Gestão de expansão do cluster
Expansões devem ser planejadas antes de a reserva de contingência desaparecer. Adicionar VMs continuamente sem recalcular N+1 pode transformar um cluster inicialmente resiliente em uma plataforma incapaz de absorver a falha de um host.
O planejamento deve definir gatilhos de expansão por CPU, memória, storage e rede. Também precisa considerar prazo de aquisição, instalação, licenciamento e compatibilidade do novo hardware com o cluster existente.
Essa disciplina evita crescimento reativo e mantém coerência entre capacidade nominal e requisito de disponibilidade.
Checklist mínimo para aceite de um cluster
Antes de liberar uma plataforma de virtualização para produção, é necessário confirmar inventário de hosts, redes, datastores, licenças, versões e políticas de HA. A capacidade residual precisa ser conhecida e compatível com os cenários de falha previstos.
Testes devem comprovar migração, perda de host, acesso ao storage, restauração de backup, redundância de uplinks e monitoramento. Também é importante verificar que contas administrativas, logs e procedimentos de manutenção estão disponíveis à equipe responsável.
O aceite termina quando a organização consegue operar, recuperar e expandir o ambiente com base em documentação e evidências, sem depender exclusivamente do conhecimento tácito de quem realizou a implantação.
Como critério final, a plataforma deve permanecer operável mesmo quando quem implantou o ambiente não está disponível. Inventário, diagramas, procedimentos de failover, backup, restauração, manutenção e expansão precisam estar documentados e testados. Essa autonomia operacional é parte do resultado de engenharia e reduz dependência de conhecimento informal.
Em termos práticos, a operação deve saber quanta capacidade ainda existe após a falha de um host, quais workloads são prioritários e quais procedimentos devem ser executados em manutenção ou contingência. Essa previsibilidade é o que transforma virtualização em infraestrutura resiliente, e não apenas em consolidação de servidores.
Considerações finais
O hypervisor é a camada que possibilita executar múltiplas máquinas virtuais sobre uma infraestrutura física compartilhada.
Seu valor está em consolidação, isolamento, mobilidade e automação.
Mas a virtualização concentra dependências.
CPU, memória, storage, rede, licenciamento, backup e HA precisam ser projetados como um único sistema.
Em ambientes críticos, uma plataforma de virtualização só deve ser considerada pronta quando sua capacidade, redundância, recuperação e operação forem comprovadas por testes e documentação.
Referências técnicas
[1] NIST. Hypervisor — CSRC Glossary. Disponível em: https://csrc.nist.gov/glossary/term/hypervisor.
[2] NIST. Security Recommendations for Hypervisor Deployment on Servers. Disponível em: https://www.nist.gov/publications/security-recommendations-hypervisor-deployment-servers.
[3] NIST. SP 800-125 — Guide to Security for Full Virtualization Technologies. Disponível em: https://csrc.nist.gov/pubs/sp/800/125/final.
Perguntas frequentes
É a camada de virtualização que gerencia máquinas virtuais e controla seu acesso aos recursos físicos do host.
Tipo 1 executa diretamente sobre o hardware ou camada mínima especializada; tipo 2 executa sobre um sistema operacional hospedeiro.
Não. Snapshot registra estado temporário da VM e não substitui uma estratégia independente de backup e restauração.
É alocar recursos virtuais acima da capacidade física nominal contando que todas as VMs não consumirão o máximo simultaneamente.
É a capacidade do cluster de recuperar ou reiniciar VMs em outro host após falha física, conforme a arquitetura da plataforma.
Considerando carga de pico, crescimento, CPU, memória, storage, rede e capacidade residual para sobreviver às falhas previstas.
