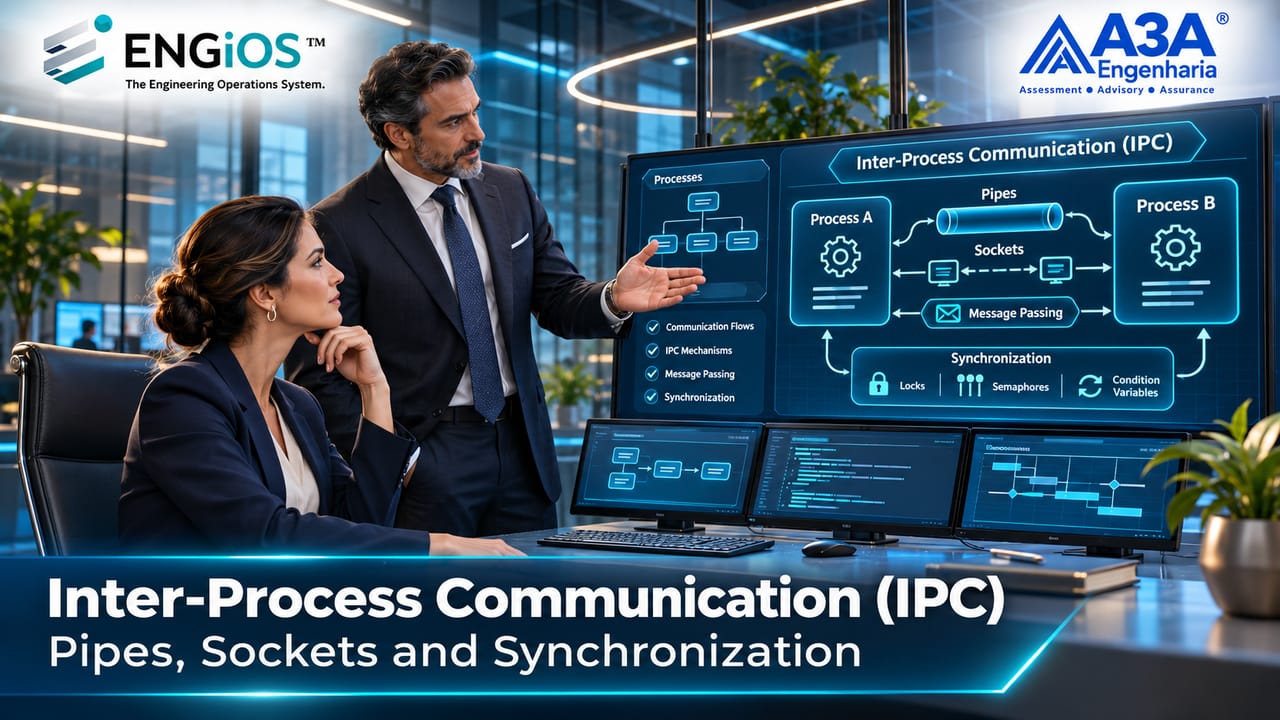
O que é IPC: pipes, FIFOs, sockets, memória compartilhada, semáforos, filas, backpressure e segurança em sistemas corporativos.
Confira!
Comunicação entre Processos (IPC) é o conjunto de mecanismos usados para trocar dados e sincronizar a execução entre processos de um sistema operacional. Pipes, FIFOs, sockets, memória compartilhada, filas e semáforos cumprem funções diferentes. A escolha depende de formato, volume de informações, latência, segurança, integridade e recuperação após falhas. Em projetos corporativos, a engenharia deve formalizar contratos de mensagens, tratamento de erros e observabilidade antes de implantar a solução.
O que é comunicação entre processos?
Comunicação entre Processos (IPC, Inter-Process Communication) é o conjunto de mecanismos que permite a processos independentes trocar informações e sincronizar operações. Sistemas operacionais isolam espaços de memória e credenciais; por isso, uma aplicação não pode compartilhar livremente um ponteiro com outro processo. Pipes, sockets, regiões de memória compartilhada e filas criam canais administrados pelo sistema e submetidos a permissões, capacidade e regras de acesso.
Um fluxo corporativo pode envolver três processos: um recebe telemetria, outro valida eventos e um terceiro registra os dados em armazenamento durável. Quando o consumidor falha, é necessário definir se o produtor bloqueia, mantém buffer, rejeita a operação ou utiliza fila persistente. IPC transporta dados, mas não estabelece automaticamente integridade, rastreabilidade ou recuperação após falhas.
O primeiro requisito é descrever o contrato entre os participantes: quem produz, quem consome, formato de mensagem, ordem, latência, volume, tamanho máximo e comportamento de erro. Processos no mesmo host podem exigir semântica de comunicação diferente daquela adotada para APIs distribuídas por rede. Esse entendimento evita tratar toda integração como simples chamada HTTP.
Pipes, FIFOs e Unix domain sockets
Pipes oferecem fluxo unidirecional de bytes por descritores de leitura e escrita. São úteis para encadear subprocessos e transportar resultados sequencialmente. A ausência de dados pode bloquear a leitura, enquanto a falta de espaço disponível pode bloquear a escrita. O aplicativo precisa tratar término de fluxo e fechamento de extremidades, além de definir como identificar mensagens em um canal contínuo.
FIFOs, ou named pipes, permitem que processos independentes acessem um canal identificado no filesystem. O nome não cria persistência durável: os bytes continuam vinculados ao mecanismo de comunicação do sistema. Portanto, FIFOs não substituem filas de eventos com retenção e confirmações de processamento.
Unix domain sockets são endpoints locais adequados a serviços independentes no mesmo host. Dependendo do tipo de socket, oferecem fluxo ou datagramas; em sistemas compatíveis, também podem permitir verificação de credenciais de pares e passagem de descritores. A escolha exige governança de permissões, ciclo de vida do endpoint, limites e tratamento de reconexão.
Os manuais pipe(7) e unix(7) explicam as propriedades concretas desses mecanismos no Linux. A implementação deve se basear na plataforma real, porque nem todo comportamento é idêntico entre sistemas operacionais.
Sockets TCP, UDP e o limite entre IPC local e rede
TCP é um transporte de fluxo de bytes que permite comunicação local ou entre máquinas. Embora preserve ordem dos bytes entregues, não preserva automaticamente os limites lógicos entre mensagens. Quem utiliza TCP precisa definir framing, como prefixo de tamanho ou delimitador, além de timeouts, autenticação, reconexão e tratamento de duplicações decorrentes de retries.
UDP opera com datagramas e não assegura entrega ou ordenação. Isso pode ser adequado quando a aplicação tolera perdas ou implementa recuperação específica, mas não deve ser escolhido como atalho genérico para reduzir latência. Para dados auditáveis e comandos críticos, os requisitos de entrega precisam ser descritos antes da escolha do protocolo.
A comparação deve incluir custo de serialização, cópias de dados, troca de contexto, latência entre produtores e consumidores, observabilidade e isolamento. Uma conexão no loopback não elimina riscos: portas podem ser acessíveis por processos indevidos, e uma aplicação comprometida pode enviar mensagens malformadas. O projeto de redes corporativas deve especificar os fluxos que atravessam zonas de segurança.
Memória compartilhada e sincronização
Memória compartilhada permite que dois ou mais processos mapeiem uma região comum e trabalhem com buffers sem exigir serialização de todos os dados em cada transferência. Em aplicações de vídeo, imagem e telemetria, esse recurso pode reduzir cópias e oferecer throughput elevado. Em contrapartida, a integridade passa a depender de regras estritas sobre publicação e consumo de registros.
Um processo não deve considerar o buffer válido apenas porque o endereço existe. É preciso definir estrutura, tamanho, versão, alinhamento, regras de acesso, indicador de disponibilidade e ordem das operações. A publicação de um registro parcialmente escrito pode gerar leitura inconsistente. Semáforos, mutexes ou outras primitivas de sincronização precisam ser selecionados conforme o modelo de concorrência.
Uma race condition acontece quando o resultado depende da ordem de execução não garantida de processos ou threads. Deadlock é o bloqueio sem progresso quando participantes aguardam condições incompatíveis. Starvation ocorre quando uma parte não consegue avançar apesar de o sistema continuar executando. Esses problemas exigem testes de stress e instrumentação; aumentar a CPU ou o buffer não corrige um protocolo de sincronização incorreto.
Filas, mensagens assíncronas e backpressure
Filas desacoplam temporalmente produtores e consumidores. Algumas são mecanismos de IPC local; sistemas de mensageria podem acrescentar persistência, roteamento e confirmações. Não é correto presumir que qualquer fila garante retenção após reinício. A especificação precisa distinguir canal de transferência, armazenamento durável e confirmação de processamento.
Em um sistema at-least-once, uma mensagem pode ser entregue novamente depois de falha ou retry. Consumidores precisam ser idempotentes para evitar cobrança, registro ou acionamento duplicado. Em at-most-once, a simplicidade pode vir acompanhada de perda. Garantias de exatamente uma vez dependem de fronteiras transacionais e não devem ser atribuídas de maneira genérica ao transporte.
Backpressure regula o ritmo do produtor diante de consumidor mais lento. Sem limites explícitos, a fila cresce até consumir recursos e elevar a latência. Defina tamanho máximo, idade admissível de mensagens, prioridades, política de descarte quando permitida e sinais de saturação. No Data Streaming corporativo, essas regras determinam como eventos são convertidos em fluxos processáveis.
Contrato de mensagens e evolução de schema
O mecanismo IPC transporta bytes ou expõe memória, mas não define seu significado. Um contrato técnico deve especificar identificador de evento, versão, campos obrigatórios, tipos, unidades, limites, erros e comportamento diante de registros inválidos. Sem governança, dois processos podem trocar bytes corretamente e ainda assim produzir interpretações incompatíveis.
Formatos como JSON e Protocol Buffers atendem necessidades diferentes de inspeção, tamanho e velocidade. A escolha deve considerar interoperabilidade e evolução de versões, e não apenas um benchmark de serialização. Em implantações graduais, produtores e consumidores podem funcionar simultaneamente com versões distintas; isso exige compatibilidade planejada.
O contrato também define identidade e correlação, de modo que uma transação possa ser rastreada entre serviços. Mensagens que não possuem identificador dificultam deduplicação e investigação. É necessário evitar incluir secrets ou dados pessoais desnecessários em logs e eventos de diagnóstico.
**Interfaces e fronteiras entre serviços.** Em um sistema com múltiplos processos, é útil desenhar o fluxo completo desde a origem do dado até a confirmação de seu processamento. Esse desenho identifica quais mensagens precisam ser entregues de forma ordenada, quais podem ser processadas em paralelo e quais exigem resposta imediata. Também identifica o domínio de falha: um pipe no mesmo host desaparece quando o processo encerra, um Unix domain socket depende de um endpoint local, e um broker com armazenamento pode manter mensagens durante indisponibilidades de consumidores. O desenho de arquitetura deve declarar essas diferenças, porque o risco real resulta da interação entre elas, não da eficiência de uma API isolada.
**Framing e integridade de registros.** Em protocolos de fluxo, duas escritas consecutivas do produtor podem ser lidas como uma sequência contínua, e uma única escrita pode exigir várias leituras para ser reconstruída. A aplicação deve definir seu próprio delimitador ou um cabeçalho de tamanho, validar os limites antes de alocar memória e tratar truncamento. Mensagens estruturadas podem carregar versão, identificador, tipo de evento, origem, timestamp e checksum quando aplicável. O checksum auxilia a detectar corrupção acidental, mas não substitui autenticação nem mecanismos criptográficos de integridade quando a ameaça envolve alteração maliciosa. Sem esse contrato, o canal pode funcionar corretamente e entregar registros interpretados de maneira errada.
**Controle de erros sem efeitos colaterais.** É necessário distinguir erro de transporte, erro de parsing, rejeição por regra de negócio e falha após execução parcial. Repetir uma operação que apenas falhou na confirmação não é equivalente a repetir uma operação que nunca chegou ao consumidor. Quando mensagens podem causar mudanças de estado, a API deve admitir identificadores idempotentes ou mecanismos transacionais. Em aplicações de segurança física, a duplicação de um comando de abertura ou a perda de um evento de acesso podem ter consequências distintas de um pacote descartado em um stream de vídeo. O comportamento de retry precisa respeitar a criticidade e a possibilidade de saber se a ação foi executada.
**Desacoplamento e versionamento.** A introdução de IPC pode melhorar separação entre processos, mas também cria dependências de schema e de ordem temporal. Um produtor atualizado pode passar a enviar campo desconhecido para um consumidor antigo; um serviço desatualizado pode rejeitar silenciosamente eventos válidos. Para evitar falhas, define-se uma política de compatibilidade e testes de versões cruzadas. Campos novos podem ser opcionais durante a transição, e mudanças de semântica devem receber versão explícita. O inventário de interfaces precisa registrar produtor, consumidor, responsável, estrutura, autenticação e procedimento de rollback, permitindo que equipes identifiquem quais componentes devem ser homologados em conjunto.
**Sincronização do tempo e rastreabilidade.** Eventos recebidos de processos diferentes podem chegar fora da ordem em que ocorreram. Timestamp não resolve isso quando os hosts estão com relógios desalinhados ou quando há buffering e reconexão. O projeto precisa indicar se a ordenação é causal, por sequência de produtor ou pelo instante de persistência. Em algumas aplicações, sequências monotônicas e identificadores de origem podem ser mais úteis que confiar apenas no horário de recebimento. A auditoria deve registrar a hora original, a chegada, o processamento e a confirmação para distinguir atraso de rede, espera em fila e efetiva ocorrência do evento.
**Testes de compatibilidade de protocolos.** Um plano de integração precisa ser reexecutado quando se troca sistema operacional, runtime ou biblioteca. Comportamentos de buffering, permissões de sockets e limites de descritores podem variar. Mesmo que duas APIs possuam o mesmo nome, diferenças de semântica devem ser avaliadas com referência à documentação da plataforma. Antes do aceite, execute testes de leitura parcial, mensagens grandes, fechamento abrupto, atualização de versão e consumidor indisponível. Registre taxa de mensagens inválidas e capacidade de recuperação, mantendo logs que ajudem a reproduzir o cenário sem expor credenciais ou conteúdo sensível.
Critérios técnicos para escolher o mecanismo de IPC
A decisão de arquitetura começa pela natureza da informação transportada. Um fluxo de bytes entre dois programas locais pode funcionar adequadamente com pipe; componentes independentes que se reconectam podem favorecer Unix domain sockets; mensagens com necessidade de retenção exigem uma fila ou broker projetado para durabilidade. O termo IPC, isoladamente, não determina nenhuma dessas escolhas. É a combinação de throughput, latência, integridade e modo de falha que conduz o projeto.
Na avaliação de memória compartilhada, registre quantos processos escrevem, quantos leem e qual o tamanho dos registros. Se há um produtor e vários consumidores, a estrutura de controle difere da situação em que vários escritores disputam a mesma região. Um ring buffer pode ser eficiente, mas exige definição de índices, wraparound, validade dos itens e política quando o consumidor se atrasa. Sem esses elementos, o ganho de desempenho não compensa o risco de corrupção.
Para chamadas síncronas, considere o efeito de falhas em cascata. Um processo que aguarda outro sem timeout pode manter recursos alocados e bloquear usuários. Retries sem controle podem ampliar a carga justamente quando o serviço está degradado. Uma especificação madura define prazo de resposta, tentativas, circuit breaker quando aplicável, limitação de concorrência e critérios para retornar erro à camada superior.
| Requisito | Canal inicial a avaliar | Limitação a documentar |
| Bytes entre processos relacionados | Pipe | Framing e fechamento de extremidades |
| Endpoint local independente | Unix domain socket | Permissões e reconexão |
| Buffer grande, alta taxa | Memória compartilhada | Sincronização e recuperação |
| Eventos com retenção | Broker ou fila durável | Confirmação, duplicidade e custos |
| Serviço entre hosts | TCP ou mensageria de rede | Segurança, latência e particionamento |
Desempenho, latência e throughput sob carga real
Um benchmark de IPC precisa distinguir tempo de envio, tempo de fila, tempo de processamento e confirmação final. Comparar duas bibliotecas por mensagens por segundo em uma única máquina pode ocultar gargalos de serialização, cache, I/O ou banco. O projeto deve medir latência média, p95 e p99, utilização de memória, CPU e tamanho dos buffers em perfis que representem o ambiente de produção.
A quantidade de cópias não é a única variável. Embora memória compartilhada possa evitar transferências desnecessárias, o protocolo de locking ou as barreiras de memória podem dominar o tempo em workloads pequenos. Por outro lado, sockets de fluxo bem projetados podem apresentar desempenho suficiente com isolamento melhor e debugging mais simples. A escolha exige comparar complexidade operacional com benefício medido.
O comportamento sob saturação é tão relevante quanto o pico de throughput. Se o consumidor processa menos mensagens do que recebe, a idade do evento mais antigo deve aumentar. O sistema precisa estabelecer o ponto em que começa a reduzir produção, descartar dados não críticos ou persistir temporariamente. Essa política não pode ser inventada durante o incidente.
Em sistemas que analisam vídeo, diferencie frames intermediários de eventos consolidados. Descartar alguns frames em visualização ao vivo pode ser tolerável, enquanto perder registros de eventos de segurança, auditoria ou transações pode ser inadmissível. Cada fluxo precisa de critérios próprios de retenção, ordenação e recuperação.
**Teste de concorrência sob estresse.** Para comprovar a integridade de IPC, o plano de testes deve variar simultaneamente quantidade de produtores, consumidores, tamanho de mensagens e duração de carga. Testes de poucos segundos costumam esconder problemas de exaustão de descritores, vazamento de memória ou crescimento ilimitado de filas. É necessário manter execuções prolongadas, registrar percentis de latência e avaliar comportamento após sucessivas reinicializações. Uma falha que ocorre somente sob pico não pode ser tratada como exceção irrelevante quando o sistema sustentará operações críticas.
**Medição de gargalos por etapa.** O tempo de ponta a ponta deve ser decomposto em preparo do payload, espera para envio, transporte, espera no consumidor, processamento e persistência. Essa separação revela se a fila está acumulando mensagens por insuficiência de CPU, lock prolongado ou banco saturado. Otimizar serialização quando o gargalo está no armazenamento produz ganho limitado. Além disso, diferenças entre média e p99 ajudam a identificar condições raras que afetam diretamente a experiência do usuário e os prazos operacionais.
**Estratégia de degradar com segurança.** Um sistema bem projetado define antecipadamente o que acontece quando os recursos ficam insuficientes. Uma aplicação pode reduzir frequência de informações secundárias ou desativar processamento não essencial para preservar eventos críticos. Porém, não deve aplicar o mesmo descarte a alarmes ou registros que exigem rastreabilidade. A política de prioridades deve ser aprovada por responsáveis pela operação e acompanhada de mecanismos para demonstrar quais informações foram preservadas, descartadas ou processadas com atraso.
**Evolução sem interromper aplicações dependentes.** Em ambientes distribuídos, trocar bibliotecas de IPC ou formatos de mensagem exige inventário das aplicações consumidoras e verificação de compatibilidade. Uma implantação gradual pode utilizar dupla leitura, adaptação temporária de mensagens ou versões em paralelo, desde que a consistência seja mantida. O processo de mudança deve conter janelas, plano de reversão e testes de ponta a ponta, evitando supor que um componente isolado reflete o comportamento de toda a arquitetura.
**Cálculo de buffer e retenção.** Um sistema que recebe dez mil eventos por minuto, por exemplo, exige uma estimativa de tamanho médio por evento, tempo de indisponibilidade tolerado e margem para picos. Multiplicar apenas a taxa média por um intervalo pode subestimar overhead de metadados, índices e confirmações. Também é necessário prever a taxa de escoamento após restabelecimento do consumidor. Se essa taxa for apenas igual à taxa de entrada, o backlog acumulado nunca diminuirá. Portanto, a capacidade de recuperação precisa superar a taxa sustentada de novos eventos.
**Integração com controle de acesso.** Quando um serviço recebe eventos de credenciais, autorizações e controladoras, identificadores de origem e sequência ajudam a distinguir tentativas distintas de duplicatas de transporte. O horário informado pelo dispositivo e o horário de recepção devem ser mantidos separadamente, pois problemas de sincronismo podem distorcer auditorias. A arquitetura também deve definir como processar eventos atrasados e qual informação pode aparecer em dashboards sem induzir interpretação errada.
**Integração com analytics de vídeo.** Um pipeline que recebe metadados de detecção de objetos ou contagem de pessoas pode gerar taxas elevadas de registros. Nem todo frame precisa ser preservado como evento de negócio; a engenharia deve identificar quais ocorrências exigem persistência e quais são temporárias. O contrato entre processos de captura, analytics e consolidação deve estabelecer formatos, timestamps, fontes, política de agregação e limites de processamento para manter indicadores comparáveis.
**Responsabilidade operacional e segregação.** Quando vários fornecedores mantêm componentes do mesmo sistema, o documento de interfaces deve atribuir responsável por cada canal, versão, credencial e política de retentativa. Uma falha entre processos não pode ficar indefinidamente sem proprietário porque cada equipe considera seu serviço disponível. A matriz de responsabilidades deve contemplar diagnóstico, aprovação de mudanças, monitoramento, testes de recuperação e comunicação dos resultados ao operador do empreendimento.
**Capacidade de auditoria e reprodução.** Investigações exigem evidências suficientes para reconstruir o caminho de uma operação, desde geração até persistência e disponibilização. Correlation IDs, registros de transformação e resultados de validação permitem conferir se um dado foi perdido, atrasado ou modificado. Por segurança e privacidade, o nível de detalhe dos logs deve ser compatível com a classificação da informação, evitando copiar senhas ou dados pessoais além do necessário.
**Revisão pós-implantação.** Após a entrada em operação, medições de desempenho e incidentes precisam ser comparadas com as hipóteses do projeto. Alterações na quantidade de dispositivos, na frequência de eventos ou no software de análise podem tornar o dimensionamento inicial insuficiente. Revisar parâmetros e contratos de mensagens periodicamente faz parte da manutenção de engenharia. A arquitetura deve conservar capacidade para expansão sem comprometer integridade, segurança ou disponibilidade dos serviços existentes.
Segurança, isolamento e validação das mensagens
IPC local não elimina fronteiras de confiança. Processos no mesmo servidor podem executar com usuários e níveis de privilégio diferentes. Um socket com permissões excessivamente abertas pode disponibilizar comandos administrativos a aplicações que não deveriam acessá-los. A configuração deve tratar proprietário, grupo, permissões, credenciais e, quando necessário, mecanismos de isolamento fornecidos pelo sistema operacional.
Todo dado recebido precisa ser considerado potencialmente inválido. Tamanho de mensagem descontrolado pode esgotar memória, e campos inesperados podem causar falhas de parsing. A aplicação deve estabelecer limites de comprimento e profundidade, validar tipos, recusar versões incompatíveis e registrar erros sem revelar conteúdo sensível. Mesmo serviços internos podem sofrer comprometimento ou enviar dados defeituosos após atualização.
Em containers, o compartilhamento de socket ou volume conecta domínios que poderiam estar isolados. É importante avaliar se o acesso ao socket do runtime, por exemplo, concede poderes administrativos indevidos sobre o host. Uma decisão aparentemente conveniente para integração pode aumentar a superfície de ataque de toda a plataforma.
Segredos e credenciais devem ser tratados separadamente do payload de eventos. Logs não precisam reproduzir dados pessoais integrais para permitir diagnóstico; identificadores de correlação e resultados de validação normalmente fornecem rastreabilidade suficiente. A política de retenção deve refletir criticidade, privacidade e obrigações aplicáveis.
Observabilidade e investigação de falhas intermitentes
Problemas de IPC frequentemente aparecem como lentidão intermitente ou inconsistência entre sistemas. A instrumentação precisa coletar quantidade de mensagens, tempo de espera, taxa de falhas, profundidade de fila, retries, desconexões e latência por etapa. Uma CPU pouco utilizada não garante que o processo esteja saudável: ele pode estar bloqueado aguardando lock, socket ou recurso externo.
Trace IDs e correlation IDs ajudam a reconstruir a cadeia de eventos. Em vez de armazenar apenas registros isolados de cada processo, associe produção, envio, recebimento, processamento e persistência ao mesmo identificador. Assim, é possível distinguir uma mensagem que nunca foi publicada de outra que foi recebida mas falhou antes do commit no banco.
Considere uma fila que acumula eventos porque o disco do consumidor ficou lento. A aplicação pode continuar respondendo a healthchecks simples, enquanto a idade do evento aumenta minuto a minuto. Um alarme de atraso e saturação revela o problema de negócio antes que os buffers se esgotem. Essa observabilidade deve orientar decisões sobre capacidade e qualidade de serviço.
Os procedimentos de suporte precisam incluir inspeção de descritores, permissões, logs, recursos de memória e métricas de comunicação. A análise de incidentes deve distinguir causa raiz de sintomas, registrar mudanças realizadas e verificar a eficácia da correção com teste de regressão.
Exemplo aplicado: eventos de CFTV e controle de acesso
Imagine uma instalação com câmeras inteligentes, controladores de acesso e plataforma de Business Intelligence. Um serviço recebe metadados de vídeo, outro normaliza eventos e um terceiro encaminha registros para análise. Alguns componentes executam no mesmo host, mas outros podem estar em uma sala técnica ou Data Center. Portanto, a engenharia precisa separar IPC local de transporte distribuído e armazenamento persistente.
O processo de captura pode utilizar buffers rápidos para dados temporários de imagem e um canal independente para eventos estruturados que exigem rastreabilidade. O processamento em memória deve ter limites de capacidade e descarte explícito quando a informação não for crítica. Já um evento de acesso deve possuir identidade, timestamp, origem, status de confirmação e política de reprocessamento conforme os requisitos operacionais.
O desenho não pode depender apenas de uma conexão contínua com o centro de dados. Em caso de queda de rede, o gateway precisa saber se armazena eventos localmente, por quanto tempo e como retoma sincronização sem produzir registros duplicados. A decisão exige análise da infraestrutura, dos riscos de perda e das necessidades do cliente.
Uma matriz de testes deve incluir reinício do processo de analytics, indisponibilidade do banco, perda de conexão e chegada de mensagens malformadas. O aceite envolve não só o estado dos serviços, mas a integridade das informações utilizadas em dashboards e investigações.
**IPC em sistemas de operação contínua.** Sistemas de monitoramento, automação e integração de dados frequentemente precisam operar por períodos extensos sem intervenção direta. A solução deve prever manutenção programada, rotação de logs, atualização de serviços, troca de certificados e reinicializações seletivas. A implantação de um novo consumidor não pode comprometer outros fluxos que compartilham o mesmo canal. É recomendável separar recursos por criticidade, aplicar quotas e estabelecer comportamento previsível quando um componente fica lento. Em infraestruturas físicas, o plano de mudança também precisa considerar horários de funcionamento, dependências com equipamentos e mecanismos de operação degradada.
**Fila temporária não é histórico operacional.** Quando um sistema recebe eventos de equipamentos e encaminha-os para um banco, o buffer local deve ter capacidade e política de descarte claramente definidas. Se a rede corporativa ficar indisponível por uma hora, calcule o volume potencial de mensagens, o espaço necessário e a taxa exigida para recuperar o atraso após o retorno. A recuperação não pode saturar as demais aplicações do host. Defina prioridades, janela máxima de atraso e integridade, distinguindo dados de telemetria que toleram perda controlada de registros auditáveis que precisam de persistência comprovada.
**Falhas em cadeia e prevenção de avalanche de retries.** Quando muitos produtores detectam indisponibilidade de um mesmo serviço, todos podem tentar reconectar ao mesmo tempo. Sem limites, esses retries aumentam a carga quando o consumidor mais precisa se recuperar. Estratégias como backoff progressivo com jitter, limite de conexões simultâneas e circuit breaker podem ajudar, desde que sejam compatíveis com os requisitos de latência. A recuperação deve evitar duplicar processamento e contabilizar as operações que permaneceram pendentes. Um teste de carga após falha de rede pode revelar riscos invisíveis em ensaios de operação estável.
**Observabilidade orientada ao serviço.** Uma métrica de disponibilidade do processo não demonstra que os eventos estão sendo processados no prazo. Indicadores úteis incluem idade do evento mais antigo, tempo de ponta a ponta, proporção de mensagens rejeitadas, quantidade de retries e atraso de confirmação. Os alertas devem ser associados a consequências operacionais: um backlog crescente pode representar perda de visibilidade de um sistema de CFTV; atraso na sincronização pode representar dashboards inconsistentes; falha de deduplicação pode gerar contagem incorreta. A medição precisa ser interpretada por responsáveis que conheçam a operação e a prioridade do fluxo.
**Documentação as-built de integração.** A entrega deve registrar implementações e versões efetivamente implantadas, portas, caminhos de socket, donos de serviço, localização de buffers, tamanho e formato das mensagens, parâmetros de retenção, credenciais, níveis de privilégio e rotinas de limpeza. Registre também dependências externas e os passos para realizar uma restauração isolada. Um runbook de incidentes deve orientar como verificar se o problema está no produtor, no transporte, na fila, no consumidor ou no banco. Essa documentação reduz o tempo de diagnóstico e evita soluções improvisadas durante indisponibilidade crítica.
**Aceite baseado em evidências reproduzíveis.** O relatório de comissionamento deve associar requisito, método de teste, resultado esperado, resultado observado, responsável e eventual desvio. Cenários que precisam ser comprovados incluem perda de processo, restart do host, saturação de buffer, mensagens fora de ordem, múltiplos produtores, falha na confirmação e restauração de conexão. Uma solução que transmite dados rapidamente, mas não consegue explicar como recupera uma mensagem perdida, não cumpriu requisito de confiabilidade. É preferível registrar restrições técnicas remanescentes e obter aceite formal do risco a declarar disponibilidade genérica sem evidência.
**Análise de carga em horário de pico.** Um sistema de eventos pode receber grande volume de dados ao abrir um edifício ou iniciar turno de produção. O plano de carga deve reproduzir essa concentração e comparar o tempo de processamento ao comportamento em operação normal. A medição precisa registrar taxas de entrada e saída e identificar quando o backlog começa a crescer. Sem essa análise, um serviço pode apresentar baixa latência em demonstração e atrasos relevantes em produção.
**Recuperação de consumidores após interrupção.** Se um processo consumidor falha, a equipe precisa demonstrar o que acontece às mensagens não confirmadas. Em canais transitórios, dados podem desaparecer; em filas duráveis, deve ser verificada a política de reentrega, retenção e deduplicação. O teste deve interromper o consumidor em pontos diferentes da transação, inclusive depois de executar a operação, mas antes de confirmar o resultado. Esse cenário diferencia robustez real de simples reinício automático.
**Controle de versão de interfaces de comunicação.** Uma atualização pode introduzir novos campos, mudar tamanhos ou alterar interpretação de códigos. O projeto deve prever período em que duas versões funcionem simultaneamente e estabelecer quais mudanças são compatíveis. A homologação precisa incluir mensagem antiga no consumidor novo e mensagem nova no consumidor antigo, quando essa coexistência for prevista. Caso contrário, uma atualização gradual pode interromper serviços que pareciam independentes.
**Testes de segurança em canais locais.** É necessário verificar tentativas de conexão por usuários não autorizados, payloads excessivos, mensagens malformadas e encerramento inesperado do emissor. O tratamento deve preservar disponibilidade e impedir escalada de privilégios. Compartilhar sockets ou volumes com containers deve ser submetido a uma análise de permissões e acesso ao host. O relatório precisa registrar evidências de bloqueio, registros de auditoria e tratamento de incidentes.
**Integridade dos dados em processos distribuídos.** Quando parte do fluxo passa de IPC local para comunicação entre máquinas, o projeto deve tratar diferenças de ordenação, sincronismo e indisponibilidade da rede. Identificadores, timestamps e contratos de mensagem ajudam a reconstruir o processamento. As equipes precisam definir se o dado foi apenas recebido, validado, confirmado ou persistido, pois cada etapa possui significado operacional diferente. Esse detalhamento evita indicadores de entrega que parecem positivos mesmo quando registros relevantes não chegaram ao destino final.
**Governança de alterações de capacidade.** Ao ampliar produtores, réplicas ou número de dispositivos, execute novamente testes de contenção, locks, limites de fila e latência. Uma configuração antes adequada pode apresentar starvation ou saturação diante de carga concorrente maior. O planejamento deve incluir margem, thresholds e critérios de expansão. É importante registrar os resultados para que aumento de recursos seja uma decisão técnica, e não resposta reativa baseada apenas em reclamações dos usuários.
**Procedimento operacional de contingência.** O runbook deve indicar como identificar o componente indisponível, isolar o problema, preservar mensagens quando possível, reiniciar serviços e conferir integridade após recuperação. Também deve atribuir responsabilidades e indicar situações que exigem escalonamento. Em ambiente com fornecedores distintos, a matriz de interfaces evita que cada equipe declare seu componente disponível enquanto o processo completo permanece interrompido. A capacidade de diagnosticar e recuperar o fluxo é parte do aceite.
Comissionamento, critérios de aceite e documentação técnica
O comissionamento começa com um conjunto rastreável de cenários. Em operação normal, meça latência e capacidade com dados representativos. Em falhas, encerre abruptamente o consumidor, reinicie o produtor, interrompa permissões e reduza disponibilidade de storage. Registre se mensagens se perdem, se são duplicadas e como cada parte se recupera.
Uma boa matriz de aceitação inclui pré-condição, estímulo, resultado esperado, evidência e responsável. Não é suficiente afirmar que um canal funciona porque dois processos conseguiram se conectar. Teste o que ocorre quando a aplicação recebe tamanho de mensagem inválido, quando sua fila atinge limite e quando uma nova versão altera o contrato de dados.
Documente formatos, versões, parâmetros de capacidade, timers, credenciais, permissões, lógica de retry, monitoramento e procedimento de recuperação. Esses registros precisam acompanhar o ciclo de mudanças do sistema; alterações em processo produtor exigem avaliação do impacto sobre consumidores e sistemas posteriores.
Na transição para operação, as equipes devem conhecer caminhos de diagnóstico, métricas, alarmes, incidentes recorrentes e procedimentos de rollback. O resultado de engenharia é a capacidade de manter o sistema funcionando ao longo do tempo, inclusive quando os responsáveis originais pela implantação não estão disponíveis.
Estruturas de dados, atomicidade e segurança de buffers
As estruturas de dados compartilhadas devem ser tratadas como contratos com invariantes verificáveis. Um buffer circular necessita regras para posição de leitura, posição de escrita, capacidade, sinalização de item completo e retorno ao início. Se esses estados forem atualizados fora de ordem, leitores podem observar um registro parcialmente produzido ou consumidores distintos podem processar o mesmo item. A implementação precisa explicitar como preserva atomicidade, visibilidade de memória e recuperação após encerramento de participante. Uma biblioteca madura pode reduzir o risco de erros difíceis de reproduzir.
O projeto também deve considerar ciclos de vida. Quem cria o objeto compartilhado, quando ele é destruído e como o sistema identifica estruturas abandonadas após falha? O controle de permissões precisa impedir que outro usuário acesse dados internos. A inicialização deve verificar versões e tamanhos da região antes de reutilizá-la. Na manutenção, alterações em layout de memória exigem uma estratégia de migração, pois diferentes versões de produtores e consumidores não podem interpretar arbitrariamente o mesmo buffer.
Resiliência, idempotência e integridade transacional
Quando uma mensagem provoca gravação no banco, acionamento de controle de acesso ou alteração de estado de equipamento, o receptor precisa identificar o momento em que pode confirmar a operação. Confirmar a entrega antes do commit cria risco de perda após falha; confirmar depois do commit pode produzir redelivery. A arquitetura deve estabelecer se a transação e o reconhecimento fazem parte da mesma fronteira de consistência ou se a idempotência será implementada pela aplicação.
Um método recorrente é associar identificador único a cada operação e manter um registro da aplicação que permita reconhecer reprocessamentos. Essa solução deve considerar retenção e concorrência, porque dois consumidores podem receber o mesmo identificador ao mesmo tempo. Uma restrição de unicidade no banco e transações apropriadas podem complementar a validação. O objetivo não é prometer ausência absoluta de falhas, mas assegurar um resultado de negócio correto quando elas ocorrerem.
Matriz de capacidade e planejamento de evolução
Antes de colocar IPC em produção, estimativas devem contemplar crescimento do volume de mensagens, tamanho máximo, concorrência e padrões de pico. Um sistema dimensionado para taxa média diária pode falhar no horário de concentração de eventos. Testes de stress devem variar o número de produtores e consumidores e medir não apenas throughput, mas latência p99, profundidade de fila e recuperação depois de saturação.
Na governança, estabeleça thresholds e responsáveis por ações quando o comportamento se aproximar dos limites. O crescimento de backlog pode exigir processamento paralelo, alteração de prioridade ou revisão de dependências mais lentas. A decisão deve preservar a semântica dos registros; adicionar consumidores sem verificar ordenação, consistência e paralelismo pode produzir falhas difíceis de identificar. O planejamento de evolução deve manter testes de compatibilidade para produtores e consumidores antigos.
**Diagramas de sequência e registros de interface.** Para sistemas de vários fornecedores, o diagrama de sequência permite representar a ordem esperada das chamadas, os pontos de confirmação, os prazos e os resultados alternativos. Ele deve mostrar também exceções, como timeout, repetição e indisponibilidade do consumidor. Isso reduz interpretações conflitantes na implantação e oferece uma referência objetiva para o comissionamento. Documentos de interface devem ser versionados e aprovados pelos responsáveis pelas duas extremidades, especialmente quando mensagens geram ações em equipamentos ou modificam dados críticos.
**Recursos do sistema operacional e limites configuráveis.** Uma implantação precisa verificar limites de arquivos abertos, processos, buffers, memória compartilhada e filas, além de monitorar como esses recursos são consumidos. Um software pode permanecer funcional em laboratório e atingir limites do host após semanas. A engenharia deve determinar se ajustes serão aplicados por sistema, serviço, container ou usuário e avaliar efeitos sobre outros workloads. Modificar limites sem corrigir vazamento de recursos apenas adia uma falha e pode aumentar o impacto sobre o restante do servidor.
**Tipos de entrega e responsabilidades da aplicação.** O termo entrega pode significar que os bytes foram enviados ao kernel, recebidos pelo outro processo, convertidos em mensagem válida, processados ou gravados de forma durável. Esses marcos são diferentes. Um protocolo deve declarar exatamente qual etapa gera confirmação e o que ocorre quando a resposta não retorna. Quando a aplicação opera com at-least-once, a lógica de negócio precisa lidar com duplicidade; quando a perda é admissível, a decisão deve ser formalizada e medida.
**Confiabilidade durante atualização de software.** Uma parada planejada oferece oportunidade de testar o encerramento gracioso de processos. O produtor pode interromper novas operações, concluir envios em andamento e registrar pendências; o consumidor pode retirar-se do recebimento, finalizar transações e preservar os dados não processados. Esses passos precisam respeitar os prazos do negócio. A capacidade de reiniciar componentes individualmente reduz impacto da manutenção e oferece evidência de que o sistema não depende de uma sequência manual desconhecida.
**Critérios de escalabilidade horizontal.** Adicionar consumidores pode aumentar throughput, mas pode alterar ordenação e provocar competição por recursos compartilhados. Antes de distribuir carga, defina se eventos de uma mesma origem precisam continuar sequenciais e se uma chave de particionamento é necessária. Verifique também se o armazenamento suporta maior número de operações simultâneas. A escalabilidade deve ser medida por ganho efetivo de processamento, consumo adicional e manutenção das garantias de integridade.
**Indicadores de desempenho contratual.** Requisitos vagos de comunicação rápida ou disponibilidade elevada não permitem aceite objetivo. Especifique volume de eventos, percentis de latência, perda tolerável, prazo de recuperação, período de retenção e níveis de criticidade. Cada indicador precisa ter método de medição, ambiente de teste e responsável pela aprovação. Essa formalização transforma o mecanismo IPC em componente de engenharia contratável e verificável, conectando a implementação de software aos objetivos operacionais do empreendimento.
**Interface testing entre fornecedores.** Quando o sistema depende de integração de equipamentos e software de fabricantes distintos, as partes devem aprovar exemplos de mensagens, códigos de erro e regras de reconexão. O teste de aceitação verifica formato, ordem, autenticação e comportamento sob perda de conectividade. Não basta comprovar que um programa recebe bytes: o requisito é que os dados sejam interpretados e persistidos corretamente na aplicação final.
**Tratamento de dados críticos.** Sistemas de segurança e automação precisam distinguir mensagens informativas de alarmes e ações com consequência operacional. O descarte de informações transitórias pode ser permitido em alguns fluxos, enquanto eventos auditáveis exigem retenção. A engenharia precisa registrar essas categorias, responsabilidades e critérios para que a equipe não aplique uma política genérica de buffer a dados com criticidade diferente.
**Manutenção evolutiva sem perda de rastreabilidade.** Mudanças de versão, infraestrutura ou linguagem de programação podem exigir revisão do contrato IPC. O procedimento deve preservar identificadores e permitir identificar a origem de cada mensagem durante a transição. Testes automatizados de compatibilidade e relatórios de operação assistida ajudam a comprovar que a atualização não produziu perda, duplicidade ou atraso incompatível com o nível de serviço.
**Decisões documentadas de arquitetura.** O registro do projeto precisa explicar por que determinado mecanismo foi adotado, quais alternativas foram avaliadas e quais limitações foram aceitas. Latência, throughput, disponibilidade, segurança e capacidade de suporte devem ser justificados por medições. Essa documentação transforma uma implementação pontual em infraestrutura tecnológica sustentável, permitindo que a organização reavalie escolhas quando a demanda ou as dependências mudarem.
**Revisão contínua após comissionamento.** A entrada em produção não encerra a avaliação. Tendências de backlog, mensagens rejeitadas, retries e tempo de processamento devem ser acompanhadas e comparadas aos critérios originais. Um aumento persistente na idade dos eventos pode indicar necessidade de ampliar capacidade ou corrigir consumidor. As ações precisam ser verificadas com novos testes, preservando evidências de melhoria.
Considerações finais
IPC é disciplina de arquitetura e confiabilidade, não apenas uma coleção de chamadas do sistema operacional. Pipes, sockets, memória compartilhada e filas atendem necessidades distintas de fluxo, isolamento, latência e coordenação. A escolha correta começa por requisitos, compatibilidade e capacidade de recuperação.
Uma integração corporativa só pode ser considerada madura quando contratos, controle de concorrência, segurança, limites de recursos e testes de falha são verificáveis. O objetivo não é simplesmente mover dados rapidamente, mas manter processos coordenados e informações íntegras durante operação, atualização e indisponibilidades.
Referências técnicas
[1] Michael Kerrisk. Linux manual page pipe(7). Disponível em: https://man7.org/linux/man-pages/man7/pipe.7.html.
[2] Michael Kerrisk. Linux manual page unix(7). Disponível em: https://man7.org/linux/man-pages/man7/unix.7.html.
[3] Michael Kerrisk. Linux manual page shm_overview(7). Disponível em: https://man7.org/linux/man-pages/man7/shm_overview.7.html.
Perguntas frequentes
IPC é a troca e a sincronização de dados entre processos separados.
Não. Pipe comum é canal transitório de bytes, não armazenamento durável.
A FIFO tem nome para acesso por processos independentes.
Não. Unix domain socket é local; TCP funciona também entre hosts.
Não. É necessário protocolo de concorrência apropriado.
É uma dependência não controlada da ordem de execução de processos.
É o controle do produtor para impedir saturação causada por consumidor lento.
Quando perda após falha não é tolerável e há requisitos de retenção e confirmação.
Use identificadores, idempotência e regras claras de retry e persistência.
Verifique permissões, autenticação aplicável, validação de mensagens e limites de recursos.